
Dieses Memo zielt darauf ab, die Funktionsweise von RDMA zu verstehen, insbesondere was erforderlich ist, um eine “RDMA-kompatible Netzwerkkarte” zu erstellen, die mit einem PCIe-Subsystem wie dem 200Gb connectX-7 verbunden ist, das in den DGX Spark (Bild rechts) integriert ist.
Beginnen wir dieses Memo mit einem Überblick über RDMA als Protokoll.
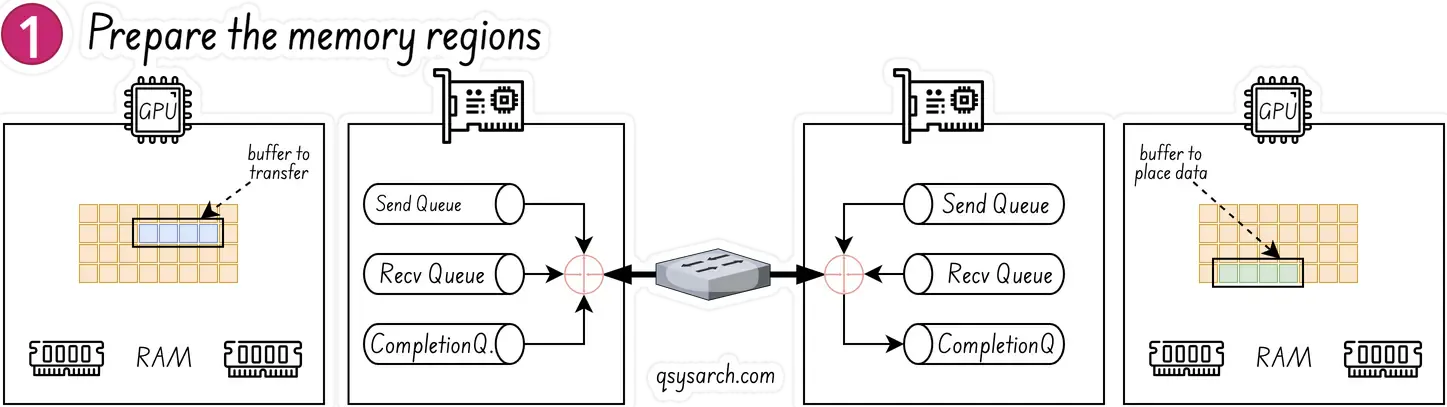
Bei der Einrichtung der RDMA-Datenkanäle müssen die Speicherpuffer vor ihrer Verwendung bei der Netzwerkkarte registriert werden. Der Registrierungsprozess umfasst die folgenden Schritte:
Speicher so fixieren, dass er nicht vom Betriebssystem ausgetauscht werden kann.
Die Adressübersetzungsinformationen werden in der Netzwerkkarte gespeichert.
Berechtigungen für den Speicherbereich festlegen.
Erstellen Sie einen Remote- und einen lokalen Schlüssel, die von der Netzwerkkarte bei der Ausführung der RDMA-Verben verwendet werden.
Die RDMA-Kommunikation basiert auf drei Warteschlangen.
Das RDMA-Warteschlangenpaar, oder QP, bezeichnet die Sende- und Empfangswarteschlange.
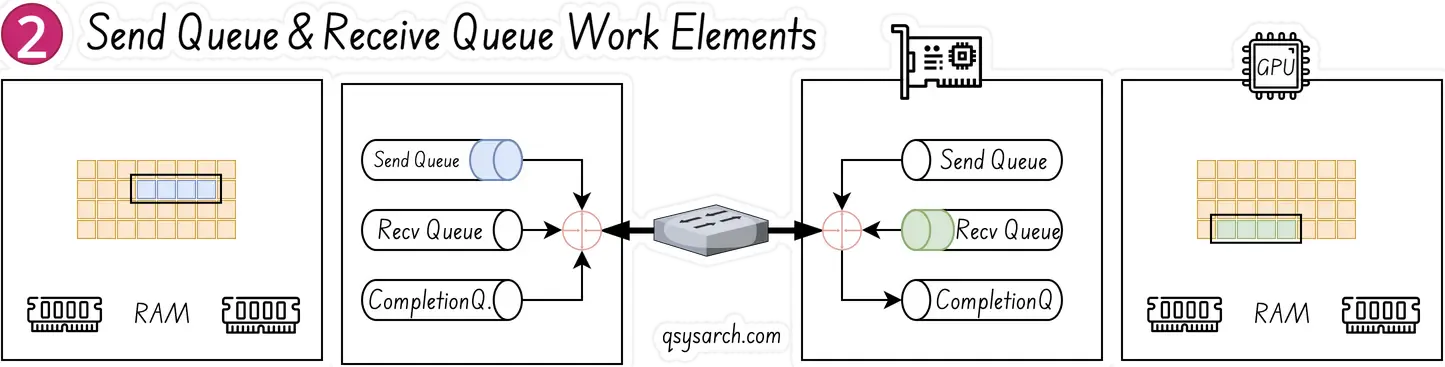
Anwendungen geben einen Auftrag mithilfe einer Arbeitsanforderung aus, die auch als Arbeitswarteschlangenelement (WQE) bezeichnet wird. Eine Arbeitsanforderung ist eine kleine Struktur mit einem Zeiger auf einen Puffer:
In einer Sendewarteschlange – es handelt sich um einen Zeiger auf eine zu sendende Nachricht.
In einer Empfangswarteschlange – zeigt sie an, wo eine eingehende Nachricht platziert werden soll.
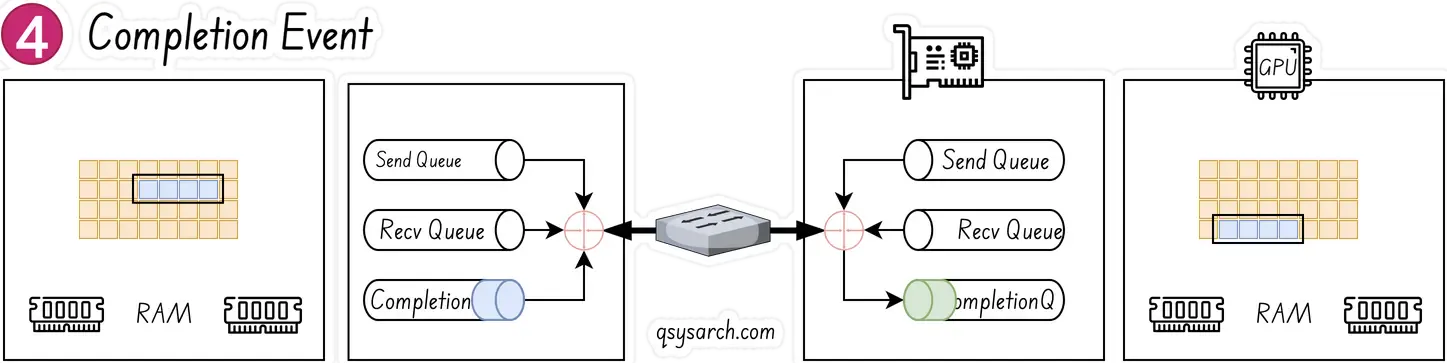
Sobald eine Arbeitsanforderung abgeschlossen ist, erstellt der Adapter ein Element für die Abschlusswarteschlange und reiht es in diese ein.
Sender (links) und Empfänger (rechts) haben ihre Warteschlangenpaare und Abschlusswarteschlangen erstellt sowie Speicherbereiche für RDMA registriert. Der Sender identifiziert einen Puffer, den er an den Empfänger übertragen möchte. Der Empfänger verfügt über einen leeren Puffer, in dem die Daten abgelegt werden sollen.
Die empfangende Entität rechts erstellt ein Arbeitswarteschlangenelement WQE WOOKIE und fügt es der Empfangswarteschlange hinzu. Dieses WQE enthält einen Zeiger auf den Speicherpuffer, in dem die Daten abgelegt werden. Die sendende Entität links erstellt ebenfalls ein WQE, das auf den zu übertragenden Puffer in ihrem Speicher verweist.
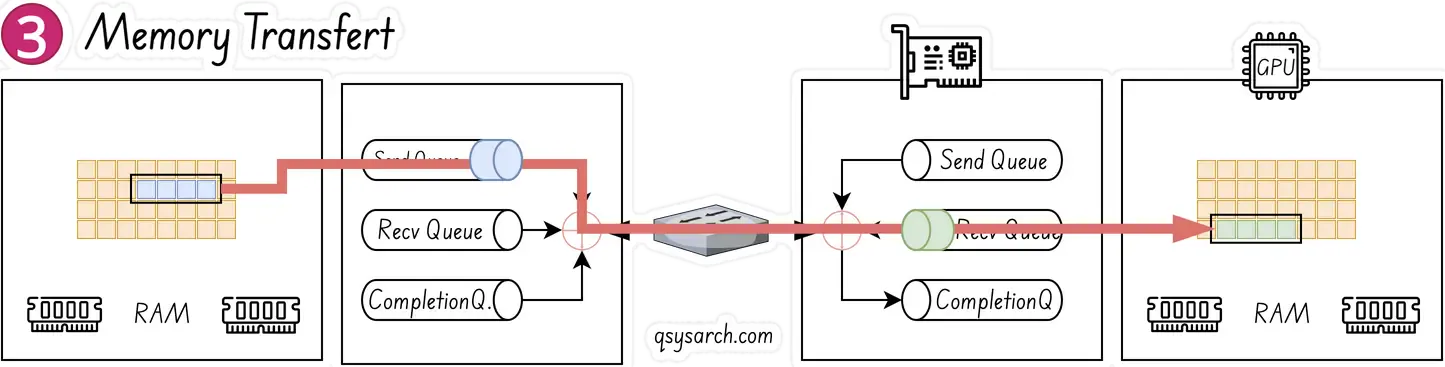
Die Netzwerkkarte (hier: die RDMA-kompatible Hardware-Netzwerkkarte, kurz RNIC) sucht permanent nach WQE-Einträgen in der Sendewarteschlange. Dies geschieht ohne Beteiligung von GPU und CPU; die Abfrage betrifft ausschließlich die RNIC. Sobald die CPU einen WQE-Eintrag sendet, verarbeitet die RNIC diesen auf dem sendenden System und beginnt mit dem Streaming der Daten aus dem Speicherbereich zum empfangenden System. Beim Eintreffen der Daten beim empfangenden System verarbeitet die RNIC den WQE-Eintrag in der Empfangswarteschlange, um die korrekte Position der Daten zu ermitteln.
Als letzten Schritt, nach Abschluss der Datenübertragung, erzeugt das RNIC ein Abschlussereignis CQE „COOKIE“, das in die Abschlusswarteschlange gestellt wird. Dieses Ereignis signalisiert den Abschluss der Transaktion. Für jedes verbrauchte WQE wird ein CQE generiert.
Bildnachweis
Wichtig ist zu beachten, dass nur die Senderseite aktiv ist; der Empfänger ist passiv; die passive Seite führt keine Operationen aus, verbraucht keine CPU-Zyklen und erhält keine Rückmeldung darüber, dass ein „Lesen“ oder ein „Schreiben“ stattgefunden hat.
Um einen RDMA-Lese- oder Schreibvorgang auszuführen, muss die Arbeitsanforderung Folgendes enthalten:
Das bedeutet, dass die aktive Seite die Adresse und den Schlüssel der passiven Seite im Voraus erhalten muss.
RDMA aus der Perspektive eines Netzwerkpakets
Link zu Überschrift
Dieser Teil basiert auf der hervorragenden Arbeit von Toni Pasanen von Network Times.
Die Anwendung auf dem Client-Rechenknoten (auch CCN genannt) initiiert den Verbindungsaufbau, indem sie eine Request for Communication (REQ)-Nachricht an die Anwendung auf dem Server-Rechenknoten (SCN) sendet.
Die REQ-Nachricht enthält ein Mittel zur Identifizierung der physischen RNIC und des Ports:
- Lokale Kommunikationskennung (
LID) und globale eindeutige Kennung für den Kanaladapter (lokale CA-GUID). Die lokale CA-GUID identifiziert die RNIC, während die lokale Kommunikationskennung den Port der NIC identifiziert.
Die REQ-Nachricht enthält außerdem alle Metainformationen über die Warteschlangenpaare.
Lokale QP-Nummer (0x1234 5678)
QP-Diensttyp (Unzuverlässige Verbindung)
Startpaketsequenznummer (PSN: 0x1882)
Partitionsschlüsselwert (0x8012)
Nutzlastgröße (1024).
Die REP-Nachricht bestätigt die QP-Metadaten. Abschließend sendet der Client eine Ready-to-Use-Nachricht (RTU) zurück, um dem Server die erfolgreiche Einrichtung der QP-Verbindung zu bestätigen. Nach Verbindungsaufbau kann die Anwendung im CCN den RDMA-Schreibvorgang starten.

Terminologie:
CCN: Client-Rechenknoten
SCN: Server-Rechenknoten
PD: Schutzdomäne
L_Key, R_Key: Lokale und Remote-Tasten
QP: Warteschlangenpaar (QP) = Sendewarteschlange + Empfangswarteschlange.
CQ: Abschlusswarteschlange
RC: Zuverlässige Verbindung
UD: Unzuverlässiges Datagramm
REQ: CCN sendet Local ID, QP-Nummer, P_Key und PSN.
Antwort: SCN antwortet mit IDs, QP-Informationen und PSN.
RTU: Einsatzbereit: CCN bestätigt die Verbindung.
WR: Arbeitsanfrage
Wird später vervollständigt – es gibt nichts Besonderes an den WR-Nachrichten, das hier erwähnenswert wäre – weitere Details finden Sie in Toni Pasanens Network Times und im InfiniBand Transport Protocol.
RDMA aus der Perspektive der Netzwerkübertragung
Link zu Überschrift
RDMA UC (Unreliable Connected) führt keine erneute Übertragung durch; stattdessen ist die Anwendung für die Zuverlässigkeitsverwaltung und den Umgang mit verlorenen Paketen verantwortlich, da UC ein verbindungsloser, unzuverlässiger Datagrammdienst ist. Die Netzwerkkarte (NIC) verwirft Pakete, ohne eine erneute Übertragung zu versuchen, und die Anwendung ist für die Nachverfolgung und erneute Anforderung fehlender Daten zuständig. Dies steht im Gegensatz zu RC-QPs (Reliable Connection), bei denen die Netzwerkhardware die erneute Übertragung übernimmt. Wie erkennt eine RDMA-UC-Anwendung also, ob ein Paket verloren gegangen ist?
- Paketverlusterkennung auf Anwendungsebene
Paketsequenznummern (PSN): Die Anwendung weist jedem gesendeten Paket eine eindeutige, fortlaufende Nummer zu. Der Empfänger speichert diese Sequenznummern. Eine Lücke in den Sequenznummern bedeutet, dass ein oder mehrere Pakete verloren gegangen sind.
Timeouts: Das Anwendungsprotokoll kann einen Timeout-Mechanismus implementieren. Wenn innerhalb eines bestimmten Zeitraums keine Antwort oder Bestätigung empfangen wird, geht die Anwendung davon aus, dass das Paket verloren gegangen ist, und initiiert eine erneute Übertragung.
- Wiederherstellung von Paketverlusten auf Anwendungsebene

Stellt der Empfänger einen Paketverlust in der Sequenz fest, muss er den Absender auffordern, dieses Paket erneut zu senden. Geht dabei auch das Paket verloren, mit dem der Absender informiert wurde, kann dies zu recht komplexen Situationen führen.
Timeout: Der Absender erwartet eine Empfangsbestätigung für die empfangenen Pakete. Andernfalls sendet der Absender das noch nicht bestätigte Paket proaktiv erneut.
Muss immer ein separates Zuverlässigkeitsmodul (siehe https://www.usenix.org/system/files/osdi23-li-qiang.pdf) zusätzlich zu RDMA QP implementiert werden? Nicht unbedingt. In manchen Situationen ist es akzeptabel, ein verlorenes Paket als Grund zu sehen, die gesamte Sitzung als fehlgeschlagen zu markieren, anstatt das fehlende Paket erneut zu senden. Dieser Ansatz funktioniert, weil das zugrundeliegende Netzwerk in der Regel zuverlässig genug ist, um eine extrem hohe Zuverlässigkeit zu gewährleisten, beispielsweise nur einen Fehler pro Billion Pakete.
Prioritätsflusssteuerung (PFC) & Explizite Staubenachrichtigung (ECN)
Link zu Überschrift
RDMA UC erkennt Paketverluste nicht automatisch, da es sich um ein unzuverlässiges Protokoll handelt. Paketverluste werden daher von der Anwendung oder einer höheren Schicht behandelt. Die „verlustfreie“ Übertragung in RDMA wird durch zugrundeliegende Netzwerktechnologien wie Priority Flow Control (PFC) und Explicit Congestion Notification (ECN) gewährleistet, die Paketverluste von vornherein verhindern.
Dieses Protokoll kapselt das RDMA-Datensegment in das UDP-Datensegment ein, fügt den UDP-Header, dann den IP-Header und schließlich den Ethernet-Header hinzu. Es handelt sich also um ein dreischichtiges Datenpaket. Die Klassifizierung erfolgt anhand des PCP-Felds im Ethernet-VLAN oder des DSCP-Felds im IP-Header.
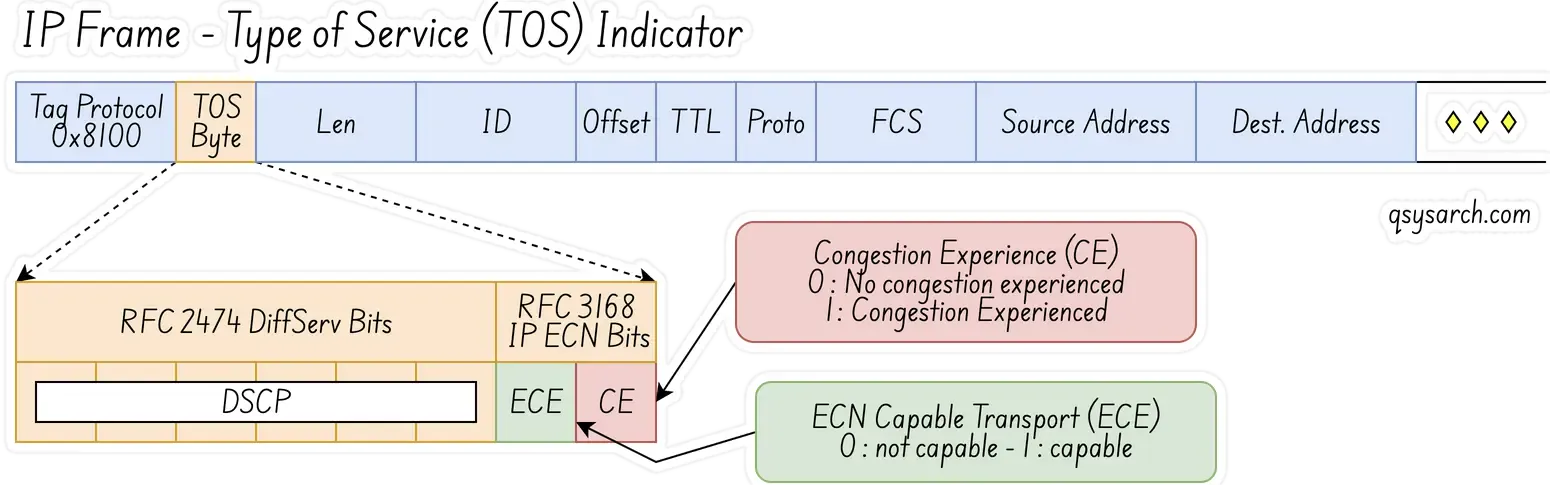
Vereinfacht ausgedrückt nutzt PFC in einem Layer-2-Netzwerk das PCP-Bit im VLAN, um Datenflüsse zu unterscheiden. In einem Layer-3-Netzwerk kann PFC sowohl PCP als auch DSCP verwenden, sodass unterschiedliche Datenflüsse unabhängig gesteuert werden können. Da die meisten Rechenzentren heutzutage Layer-3-Netzwerke nutzen, ist die Verwendung von DSCP vorteilhafter als die von PCP.
Bildnachweis
Die PCIe-Analyse basiert auf dem hervorragenden Paper: SmartIO: Zero-overhead Device Sharing through PCIe Networking von Dolphin.
Das charakteristische Merkmal von PCIe ist, dass Geräte im selben Adressraum wie CPU und Systemspeicher abgebildet werden, wie in der Abbildung rechts dargestellt. Aufgrund dieser Abbildung kann eine CPU auf den Gerätespeicher genauso zugreifen wie auf den Systemspeicher. Dies wird häufig als speicheradressierte Ein-/Ausgabe (MMIO) bezeichnet.
Bei der Initialisierung, wenn das System den PCIe-Baum prüft, wird für die Speicherbereiche jedes Geräts ein Speicheradressbereich (vom BIOS oder Kernel) reserviert. Diese reservierte Adresse wird anschließend in die Basisadressregister (BARs) des Geräts geschrieben. Ein Gerät kann bis zu sechs BARs besitzen.
PCIe verwendet Message-Signaled Interrupts (MSI) anstelle von physischen Interruptleitungen. Geräte, die MSI unterstützen, senden einen Speicherzugriff an die CPU, wobei eine spezifische Adresse und Nutzdaten vom System vorgegeben werden. Die CPU liest diesen Speicherzugriff und löst anhand der Informationen einen Interrupt aus.
MSI-X ist eine Erweiterung von MSI, die bis zu 2048 verschiedene Interruptvektoren ermöglicht. Ein Vorteil besteht darin, dass ein MSI-X-Interrupt in Mehrkernsystemen einen bestimmten CPU-Kern ansprechen kann. Darüber hinaus können verschiedene MSI-X-Vektoren unterschiedliche Ereignisse signalisieren.
[1] GPU-zu-GPU-Kommunikation über zwei CPU-Sockel: Im herkömmlichen Design kann dieser Pfad zu Engpässen durch die Host-CPU und die Verbindung zwischen den Sockeln führen, wodurch die Übertragungsrate je nach Auslastung der Verbindung zwischen den CPUs auf 25 GB/s oder weniger begrenzt wird. Im Gegensatz dazu ermöglicht das optimierte, auf CX8 basierende Design eine E/A-Bandbreite von bis zu 50 GB/s pro GPU für die gesamte Kommunikation zwischen den GPUs innerhalb des Clusters, da NCCL den gesamten Datenverkehr direkt über das Netzwerk leitet.
[2] GPU-zu-NIC-Kommunikation: Die optimierte Architektur stellt jeder GPU eine Bandbreite von 50 GB/s in einer 2:1 GPU-zu-NIC-Konfiguration zur Verfügung, unabhängig davon, ob die GPU oder das Hostsystem PCIe Gen5 oder Gen6 unterstützt.
[3] GPU-zu-GPU über denselben PCIe-Switch: Systeme, die mit PCIe Gen6 ausgestattet sind, profitieren von der doppelten Bandbreite im Vergleich zu Gen5, was die Peer-to-Peer-GPU-Übertragungen über denselben PCIe-Switch erheblich beschleunigt.
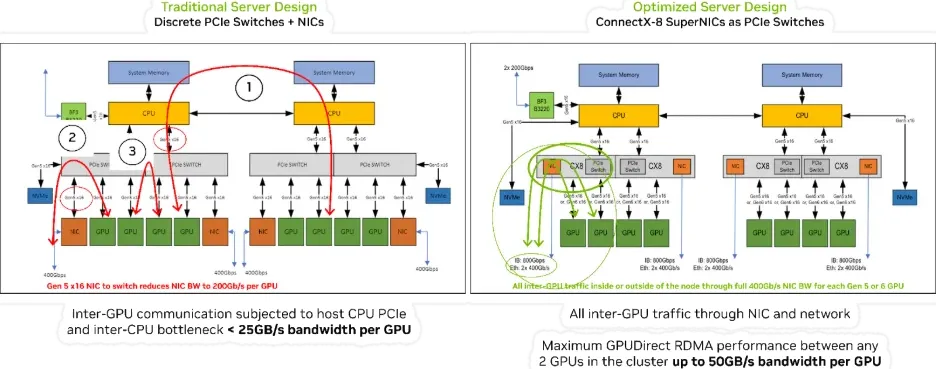
Referenz: NVIDIA ConnectX-8 SuperNICs Plattformarchitektur
RDMA aus der Perspektive einer programmatischen API
Link zu Überschrift
Dieser Abschnitt basiert auf dem Netdev 0x16 RDMA-Tutorial.
Erstellen Sie die erforderlichen Objekte einschließlich PD und CQ.
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
Einen Puffer zur Datenaufnahme reservieren und bei libibverbs registrieren:
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
Ähnlich wie Sockets, jedoch mit einer asynchronen, ereignisgesteuerten Schnittstelle. (Nicht unbedingt erforderlich, bietet aber eine Abstraktion, die mehrere Transportprotokolle abdeckt.) Zuerst wird ein „Ereigniskanal“ erstellt:
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
Beide Seiten lösen die Serveradresse auf:
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
Die passive Seite (SCN) erstellt und bindet eine Listen-“ID” und lauscht:
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
Die aktive Seite erstellt eine ID und ermittelt die Adresse des Servers:
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
Ereignisschleife zur Behandlung von Verbindungsereignissen:
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
Wichtige Ereignisse, die zu behandeln sind:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
Füllen Sie eine Streuliste aus und reihen Sie Arbeitsanfragen in die Empfangswarteschlange ein:
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
Füllen Sie eine Sammelliste aus und stellen Sie eine Arbeitsanforderung in die Warteschlange, um sie zu senden:
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
Nicht blockierende Prüfung auf Einträge in der Abschlusswarteschlange
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
RDMA aus einer GPU-direkten Perspektive
Link zu Überschrift
Hier wird es …sehr… verwirrend. Welcher Zusammenhang besteht zwischen „GPUDirect RDMA“ und RDMA? Wie bereits in einem früheren Beitrag erwähnt, besagt die offizielle Dokumentation von Nvidia, dass es keinen Zusammenhang gibt! Um das zu verstehen, müssen wir zu den Anfängen zurückkehren, als es sich noch um eine Mellanox-Technologie handelte, etwa um das Jahr 2016. Die Spezifikation besagte damals Folgendes:
Die neueste Weiterentwicklung in der GPU-zu-GPU-Kommunikation ist GPUDirect RDMA. Diese neue Technologie bietet einen direkten P2P-Datenpfad (Peer-to-Peer) zwischen dem GPU-Speicher und den NVIDIA HCA/NIC-Geräten. Dadurch wird die Latenz der GPU-zu-GPU-Kommunikation deutlich reduziert und die CPU vollständig entlastet, sodass sie nicht mehr an der gesamten GPU-zu-GPU-Kommunikation im Netzwerk beteiligt ist.
In der GPUNetIO-Spezifikation (https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html#src-4012579584_id-.DOCAGPUNetIOv3.1.0-EnablingNIC-GPUMemoryInteraction) wird erwähnt, dass zur Aktivierung der NIC-GPU-Speicherinteraktion Folgendes erforderlich ist:
Um die Netzwerkkarte (NIC) für das Senden und Empfangen von Paketen mithilfe des GPU-Speichers zu aktivieren, laden Sie das NVIDIA-Kernelmodul nvidia-peermem, das üblicherweise mit der CUDA Toolkit-Installation mitgeliefert wird.
Eine GPU-Paketverarbeitungsnetzwerkanwendung kann in zwei grundlegende Phasen unterteilt werden:
Konfigurationsphase auf der CPU (Gerätekonfiguration, Speicherzuweisung, Start der CUDA-Kernel…)
Datenpfadphase, in der GPU und Netzwerkkarte interagieren, um ihre Funktionen auszuführen
Während der Einrichtungsphase auf der CPU müssen Anwendungen Folgendes beachten:
Bereiten Sie alle Objekte auf der CPU vor.
Exportiere einen GPU-Handler dafür.
Starten Sie einen CUDA-Kernel, indem Sie den GPU-Handler des Objekts übergeben, um während des Datenpfads mit dem Objekt zu arbeiten.
Aus diesem Grund besteht DOCA GPUNetIO aus zwei Bibliotheken:
libdoca_gpunetio mit Funktionen, die von der CPU aufgerufen werden, um die GPU vorzubereiten, Speicher und Objekte zuzuweisen.
libdoca_gpunetio_device mit Funktionen, die von der GPU innerhalb von CUDA-Kerneln während des Datenpfads aufgerufen werden
Dies ist der allgemeinste Anwendungsfall für den Empfang und die Analyse von Paket-Headern. Der für den UDP-Verkehr zuständige CUDA-Kernel ist für die Verarbeitung von 100 Gbit/s eingehendem Netzwerkverkehr ausgelegt und verwendet dafür einen separaten CUDA-Block mit 512 CUDA-Threads (Datei gpu_kernels/receive_udp.cu).
Der Datenpfad ist:
Empfangen Sie Pakete mit der GPUNetIO-Funktion doca_gpu_dev_eth_rxq_receive_block.
Jeder CUDA-Thread verarbeitet eine Teilmenge der empfangenen Pakete.
Rufe den DOCA-Puffer ab, der das Paket enthält.
Analysieren Sie die Paketnutzdaten, um DNS-Pakete von anderen generischen UDP-Paketen zu unterscheiden.
Löschen Sie die Paketnutzdaten, um sicherzustellen, dass alte Pakete nicht erneut analysiert werden.
Jeder CUDA-Block sendet Statistiken an den CPU-Thread mithilfe eines DOCA GPUNetIO-Semaphors.
Der CPU-Thread prüft die Semaphore, um die Statistiken zu erhalten, und gibt sie auf der Konsole aus.
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
Im obigen Beispiel kommt RDMA nicht zum Einsatz. GPUNetIO ermöglicht es der GPU lediglich, die Paketdaten direkt zu verarbeiten. Die einzige Ähnlichkeit zu RDMA besteht darin, dass das Paket per DMA-Direkttransfer von der Netzwerkkarte zur GPU übertragen wird und dabei den CPU-Speicher umgeht.
Bevor wir zum Schluss kommen, bleibt noch ein Punkt unklar: DOCA RDMA. Im vorherigen Abschnitt haben wir uns mit DOCA GPUNetIO beschäftigt. Doch was genau ist DOCA RDMA, und wie unterscheidet es sich von der zuvor betrachteten „ibv“-API?
Die Antwort ist einfach: DOCA RDMA ist NVIDIAs Software-Framework für RDMA-Operationen, die entweder auf der CPU oder der GPU ausgeführt werden. IBV ist die traditionelle, hardwarenahe InfiniBand-Verbenbibliothek und Teil der Standard-API für die Programmierung von InfiniBand- und RoCE-Hardware. Der entscheidende Unterschied besteht darin, dass DOCA RDMA ein umfassenderes SDK höherer Ebene ist, das auf den grundlegenden Funktionen der Verbenschnittstelle aufbaut und GPU-Beschleunigung sowie die Auslagerung von RDMA-Aufgaben von der CPU auf die GPU ermöglicht.
Hier ist beispielsweise der Code zum Senden eines RDMA-Pakets:
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
Mal anders denken: Was wäre, wenn nicht RDMA?
Link zu Überschrift
Im vorherigen Abschnitt haben wir verschiedene Aspekte von RDMA untersucht. Das Hauptziel von RDMA ist die Datenübertragung zwischen CPUs, GPUs und dem Quantensteuerungs-Stack mit einer Latenz von wenigen Mikrosekunden. Dabei müssen zahlreiche Informationen übertragen werden, darunter I/Q-Soft-Readout-Daten, Steuerimpuls-Samples („Wellen“) oder die parametrische Konfiguration der Impulse, üblicherweise im Kontext eines neuronalen Netzes. Darüber hinaus müssen auch einfachere Informationen, wie die Syndrome logischer Qubits, übertragen und ein QEC-Decoder in der Recheneinheit per Fernzugriff aufgerufen werden. Im letzteren Fall kann man die Vorgehensweise einfach als „Remote Procedure Call“ (RPC) bezeichnen.
 Erfreulicherweise gibt es zahlreiche Veröffentlichungen zu RPC über RDMA, beispielsweise zu mRPC. Diese Veröffentlichung präsentiert sehr interessante Latenzwerte, basierend auf der 100-Gbit/s-Netzwerkkarte Mellanox Connect-X5 RoCE. Allerdings herrscht in der Veröffentlichung Verwirrung, da dort behauptet wird, dass „mRPC über RDMA eRPC hinsichtlich der mittleren und der maximalen Latenz um das 1,3- bzw. 1,4-Fache beschleunigt“, während die Tabelle zeigt, dass eRPC schneller als mRPC ist. Dennoch kann man vorerst davon ausgehen, dass die Latenzwerte empirisch erreichbar sind.
Noch interessanter ist die Nachfolgestudie zu mRPC Paper, in der ein Compute Express Link (CXL) verwendet wird, um einen noch schnelleren RPC zu realisieren, den sie „HydraRPC“ nennen. Die Zahlen sprechen für sich (siehe Tabelle rechts). Die Frage ist nun: Wie wird sich das in fünf Jahren entwickeln? Meiner Meinung nach bietet NVLink ebenfalls eine sehr attraktive Möglichkeit.
Voilà, es hat länger gedauert, dieses Memo fertigzustellen, aber ich denke, es hat mir geholfen, es etwas besser zu verstehen. Ich glaube, die Verwirrung zwischen RDMA und GPUDirect rührt daher, dass RDMA ursprünglich von Mellanox als reine Netzwerkverbesserung entwickelt wurde. Nach der Übernahme von Mellanox durch Nvidia wurde es erweitert, um eine Verbindung zur GPU herzustellen. Diese Erweiterung war jedoch nie als von Anfang an geplant und wurde schließlich als Add-on in das DOCA-Ökosystem integriert.

References:
DrawIO diagrams used in this memo: