Dieses Dokument behandelt die Grundlagen der GPU-Nutzung. Es konzentriert sich auf die zentrale Operation des Deep Learning: die Matrixmultiplikation. Zunächst beschreibe ich die grundlegende und akademische Implementierung. Anschließend gehe ich auf die Optimierungen ein, die für eine effiziente GPU-Nutzung notwendig sind.
Den naiven Matrixmultiplikator verstehen
Link zu Überschrift
Beginnen wir mit diesem einfachen Beispiel, das man oft in Lehrbüchern findet.
/**
* Kernel to perform matrix multiplication C = A × B
* A is of size N x M, B is M x N, and C is N x N
* Each thread computes one element of matrix C.
*/

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

// Calculate global row and column for this thread
int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

if (row < N && col < N) {
float sum = 0.0f;
for (int k = 0; k < M; k++) {
// C[row][col] = sum(A[row][i] * B[i][col])
sum += A[row * N + k] * B[k * N + col];
}
C[row * N + col] = sum;
}

}
Auf den ersten Blick erscheint dies einfach. Man berechnet einfach jede Zelle der Ausgabematrix C. Dieser Kernel-Code scheint die Aufgabe zu erfüllen. Hier ist eine anschaulichere Darstellung des Kernels.
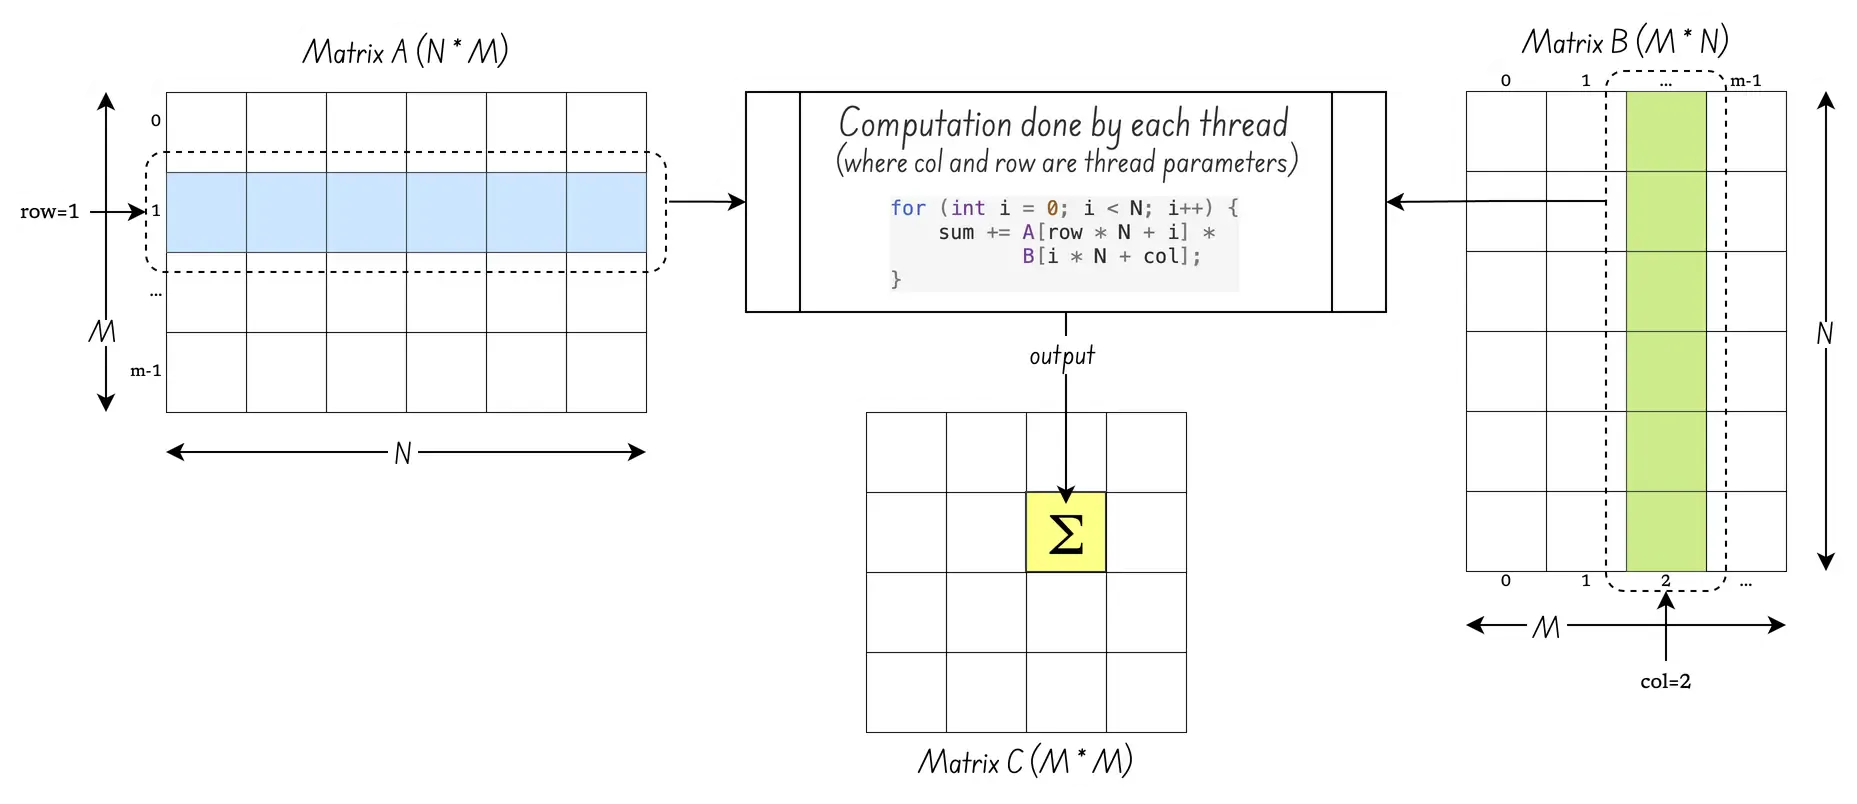
Die Realität ist etwas komplexer. Wie lassen sich blockIdx, blockDim und threadIdx interpretieren? Um das zu verstehen, müssen wir uns ansehen, wie GPUs mithilfe von Threads, Warps und Streaming-Multiprozessoren organisiert sind. Hier ist eine subjektive Darstellung der „Hopper“-GPU-Mikroarchitektur der H100-Architektur von Nvidia:
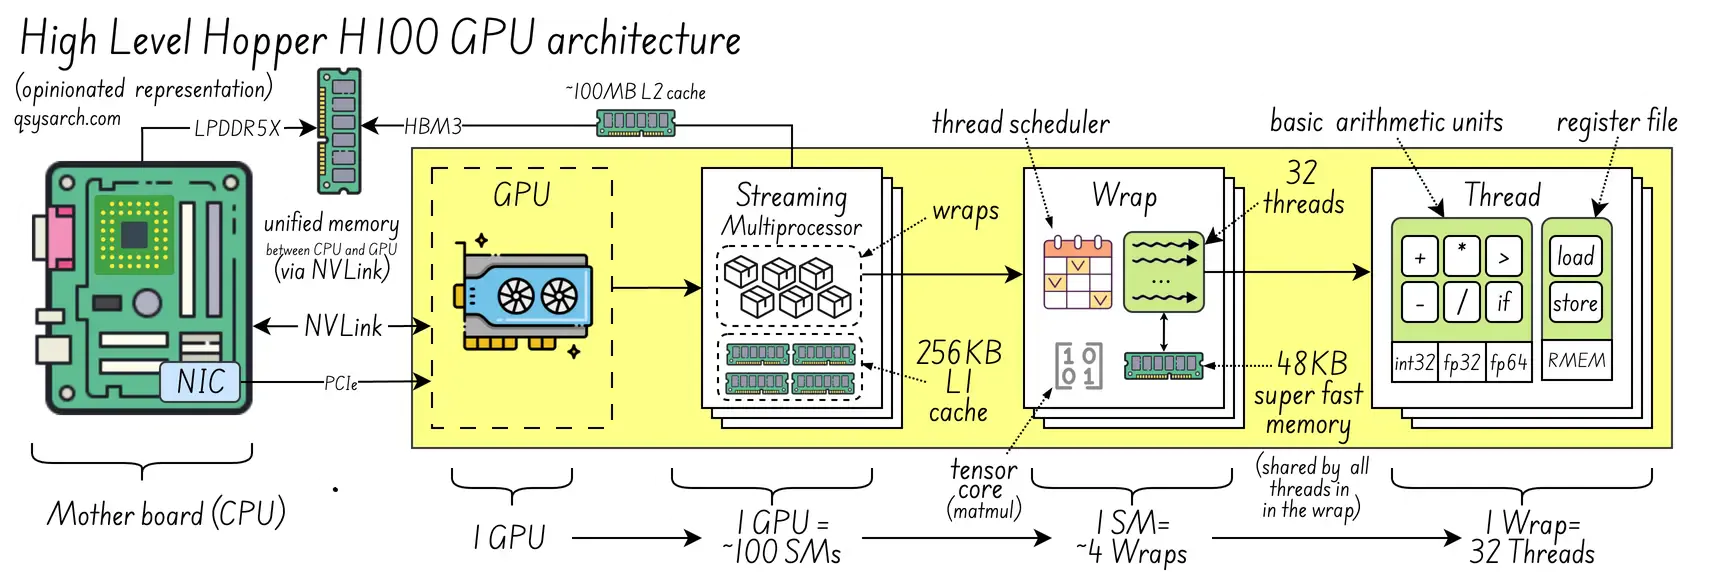
Auf hohem Niveau:
1 GPU = 10 ~ 100 Streaming-Multiprozessoren
1 Streaming-Multiprozessoren = 4 ~ 64 Wraps
1 Wicklung = 32 ~ 64 Fäden
Aber wie genau wird das Codefragment, das sum berechnet, einem Thread, Warp oder gar einem Streaming-Multiprozessor zugeordnet? Wo werden die Entscheidungen zur Speicherzuordnung und -abbildung getroffen? Zunächst müssen wir verstehen, wie der Kernel konfiguriert ist:
int launch_kernel(float *d_A, *d_B, *d_C) {

dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

// 2. Launch the kernel with the specified dimensions
naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
Diese hierarchische Konfiguration wird wie folgt auf die GPU-Hardware abgebildet:

Mit dieser Konfiguration lässt sich eine Matrix der Größe N von 16*4 = 64 multiplizieren. Was passiert, wenn N 1000 wäre? In diesem Fall muss die Gittergröße lediglich auf (1000+15)/16 gesetzt werden.
Wie sieht es mit der Zuordnung zur tatsächlichen Hardware aus? Bedeutet das, dass Blöcke Warps zugeordnet werden? Was passiert, wenn die Anzahl der Threads im Block größer ist als die Anzahl der Hardware-Threads?
Hier kommt die GPU-Planung ins Spiel. Vereinfacht gesagt: Wenn mehr Threads benötigt werden, als die physische Hardware Threads bietet, allokiert die GPU mehrere Warps.
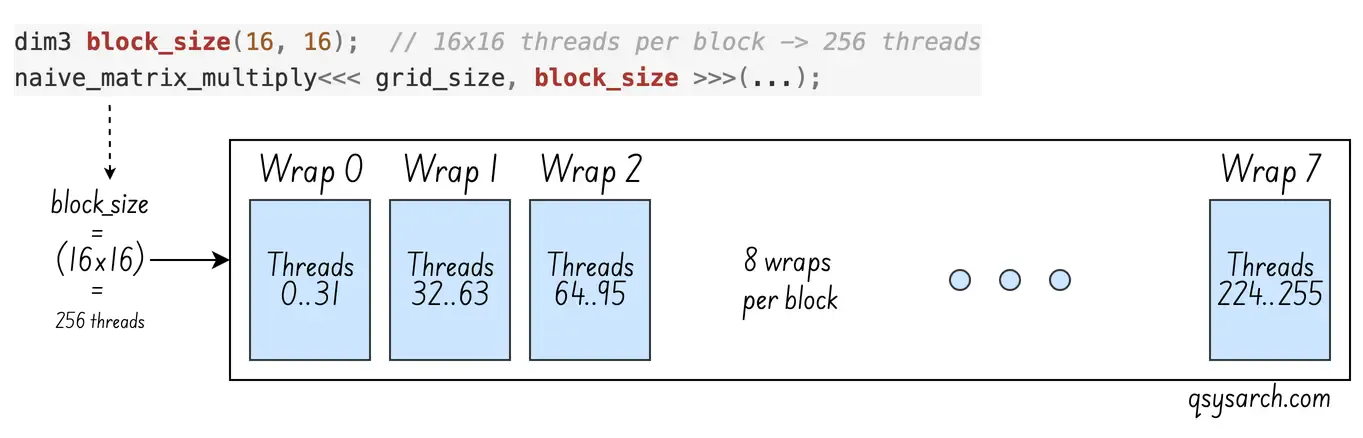
Die nächste Frage ist, wie die 8 benötigten Warps pro Block mit dem Streaming-Multiprozessor zusammenhängen, insbesondere wenn ein Streaming-Multiprozessor weniger Warps besitzt, als ein Block benötigt. Die Antwort ist genial: Ein Streaming-Multiprozessor kann mehr als 4 Warps haben, die er abwechselnd einplant: Sobald ein Warp aufgrund eines Speicherzugriffs blockiert ist, wechselt der Streaming-Multiprozessor sofort zu einem anderen Warp. Dies wird als Latenzversteckung bezeichnet und ist die grundlegende Leistungsstrategie der GPU. Ohne sie wäre die Effizienz nicht so hoch.
Betrachten wir nun grid_size. Ist grid_size direkt Hardware-Ressourcen zugeordnet? Nein. Das Grid ist lediglich ein logisches Konzept. Es stellt sicher, dass genügend Blöcke zur Abdeckung der Matrix verfügbar sind. grid_size entspricht nicht der Hardware. Die Blöcke werden den einzelnen SMs zur Laufzeit aus einer Warteschlange zugewiesen.
Die Zuweisung basiert auf den Ressourcen, die der Block benötigt (jeder Wrapper hat eine begrenzte Anzahl von Registern, und es muss sichergestellt werden, dass jedem Block ein eigener Satz von Registern statisch zugewiesen wird).
Sobald ein Block seine Berechnung abgeschlossen hat, zieht der SM einen neuen Block aus der Scheduler-Warteschlange, um den abgeschlossenen Block zu ersetzen. Nach der Zuweisung wird der Block an diesen SM gebunden und seine Register werden für die Ausführung reserviert.
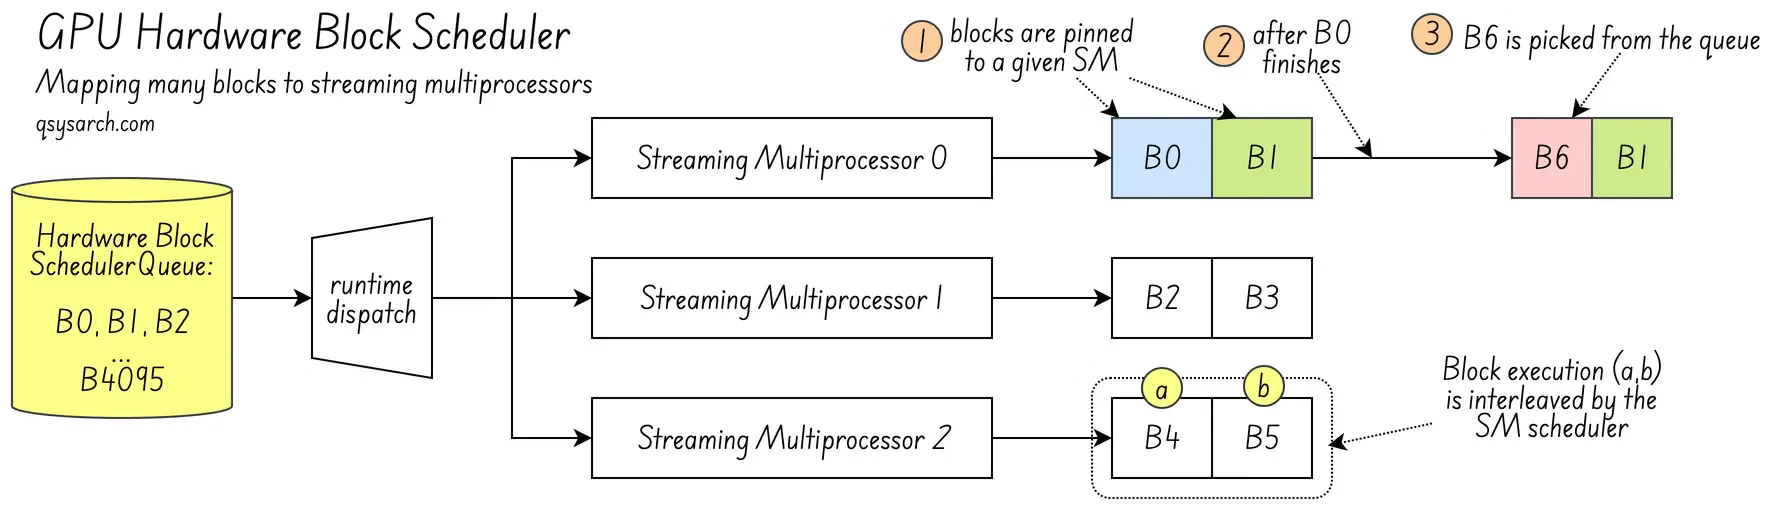
Eine letzte Frage: Sind Blöcke an den SM oder an Warps gebunden? Wird der von Threads im Block verwendete Speicher im Warp allokiert? Falls nicht, müsste der SM Speicher zwischen Warps verschieben. Ja, innerhalb des SM sind die Warps eines Blocks gebunden. Wenn Block 0 Warp 0 und Block 1 Warp 1 allokiert ist, bleibt dies immer der Fall.
Verbesserung des naiven Matrixmultiplikators
Link zu Überschrift
Nachdem wir die parallele Thread-Ausführung verstanden haben, betrachten wir den einfachen Matrixmultiplikations-Kernel. Alle Threads konkurrieren um den Speicherzugriff auf die Matrizen A und B. Jeder Thread liest eine ganze Zeile von A und eine Spalte von B aus dem globalen Speicher. Es findet keine Wiederverwendung statt. Auf B wird spaltenweise zugegriffen (B[i * N + col]), sodass Burst-Zugriffe und Speicher-Caching nicht effektiv genutzt werden können.
Die einfachste Lösung ist die Verwendung von gemeinsamem Speicher. Zuerst wird ein Teil der Matrix als Kachel der Größe T×T in den Warp-Speicher geladen. Anschließend dürfen Threads nur aus diesem lokalen Speicher lesen. Dadurch konkurrieren die Threads nicht um den Speicherzugriff. Durch Warp-Interleaving stellt der SM sicher, dass während ein Warp Daten in den Cache lädt, der andere Warp die Summe berechnet. Hier ist der erweiterte Kernel:
__global__ void matmul_tiled(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x,  ty = threadIdx.y;
int row = blockIdx.y * T + ty;   // global row in C
int col = blockIdx.x * T + tx;   // global col in C

float accumulator = 0.0f;
for (int t = 0; t < M; t += T) {

// Read [T,T] subtile from matrix A and B.
// Assume that M and N are multiples of T (no bound check)
A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();   // wait all threads to finish loading

for (int k = 0; k < TILE; ++k)
accumulator += A_shared[ty][k] * B_shared[k][tx];

__syncthreads();   // all threads are ready to load again
}
C[row * N + col] = accumulator;
}
Der Einfachheit halber gehe ich davon aus, dass M und N Vielfache von T sind, sodass beim Laden der globalen Matrix in A_shared und B_shared keine Bereichsprüfung stattfindet.
Dieser Code enthält eine kleine Besonderheit. Alle Threads im Block führen denselben Speicherlesevorgang aus: A[row * M + t + tx]. Da t zusammenhängend ist, lesen die Threads aus demselben Speicherbereich. Dies ermöglicht Speicher-Bursts und Caching. Der erste Thread initiiert den Burst-Lesevorgang. Andere Threads verwenden den durch diesen Burst gefüllten Cache. B ist nicht transponiert, daher funktioniert dieser Trick für B nicht. Außerdem synchronisiert __syncthreads() die Threads innerhalb eines Blocks und stellt so sicher, dass sie auf demselben SM ausgeführt werden.
Beim vorherigen naiven Multiplikator war die Blockgröße beliebig. Beim gekachelten Ansatz muss die Blockgröße der Kachelgröße T*T entsprechen, wie das Diagramm zeigt:
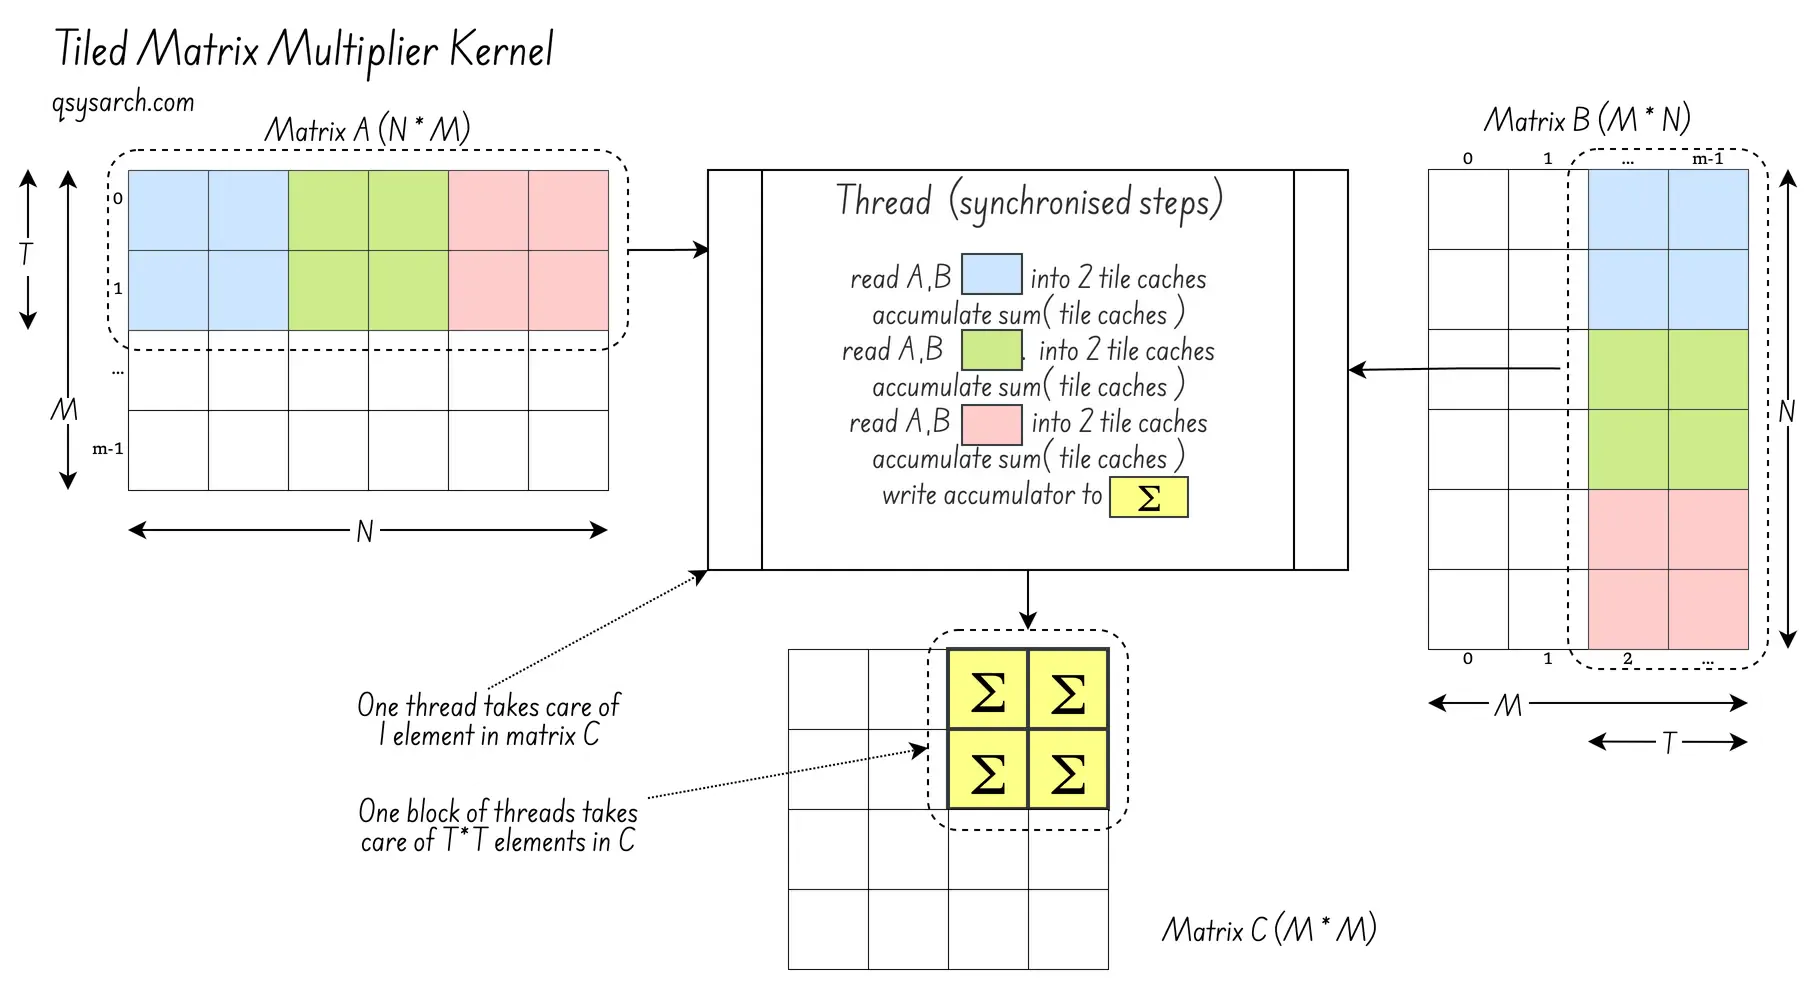
Der gekachelte Ansatz ermöglicht es Blöcken, Daten zu laden, während andere Berechnungen durchführen. In diesem Fall kann die Berechnung weniger Zeit in Anspruch nehmen als das Laden von Daten aus dem Speicher. Um dies zu beheben, kann die Arbeitslast pro Thread während der Berechnung erhöht werden. Jeder Thread kann dann eine 2x2-Elementmenge anstatt nur eines Elements berechnen. Mit K=2 und T als Vielfaches von K ist dies möglich.
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x, ty = threadIdx.y;
int rowBase = blockIdx.y * T * K + ty;
int colBase = blockIdx.x * T * K + tx;

float accumulators[K][K]; // That's register memory

for (int t = 0; t < M; t += TILE) {

A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();

for (int k = 0; k < TILE; ++k)
for (int wr = 0; wr < K; ++wr)
for (int wc = 0; wc < K; ++wc)
acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

__syncthreads();
}

// Write out the T×T accumulated result
for (int wr = 0; wr < T; ++wr)
for (int wc = 0; wc < T; ++wc) {
int r = rowBase + wr * (T/K);
int c = colBase + wc * (T/K);
C[r * N + c] = acc[wr][wc];
}
}
Voilà. So funktioniert im Prinzip eine GEMM-Einheit (General Matrix Multiplication)!
Als Nächstes sollte ich spezielle Hardware wie Tensor Core (NVIDIA) oder Matrix Fused Multiply-Add (AMD) vorstellen. Das sind spezialisierte Einheiten im Streaming-Multiprozessor, die die akkumulierten Multiplikationen T*T*K berechnen. Dazu mehr in einem späteren Memo!
References:
DrawIO diagrams used in this memo: