Beim Kompilieren für NVIDIA-GPUs gilt CUDA oft als Referenz-Compiler-Framework. Doch wie funktioniert der Compiler eigentlich? Welche Befehlssatzarchitektur (ISA) muss er generieren, um eine ausführbare Datei für die GPU zu erstellen? Und welche Architektur wird verwendet, um Code zu generieren, der von der CPU gestartet und auf der GPU ausgeführt werden kann?
Dieses Memo vom Sonntagmorgen bietet einen allgemeinen Überblick über die NVIDIA-GPU-Compilerarchitektur. Es behandelt den GPU-Befehlssatz, den NVCC-Compiler im CUDA-Framework und schließlich alternative Architekturen, die auf den GPU-Befehlssatz abzielen.
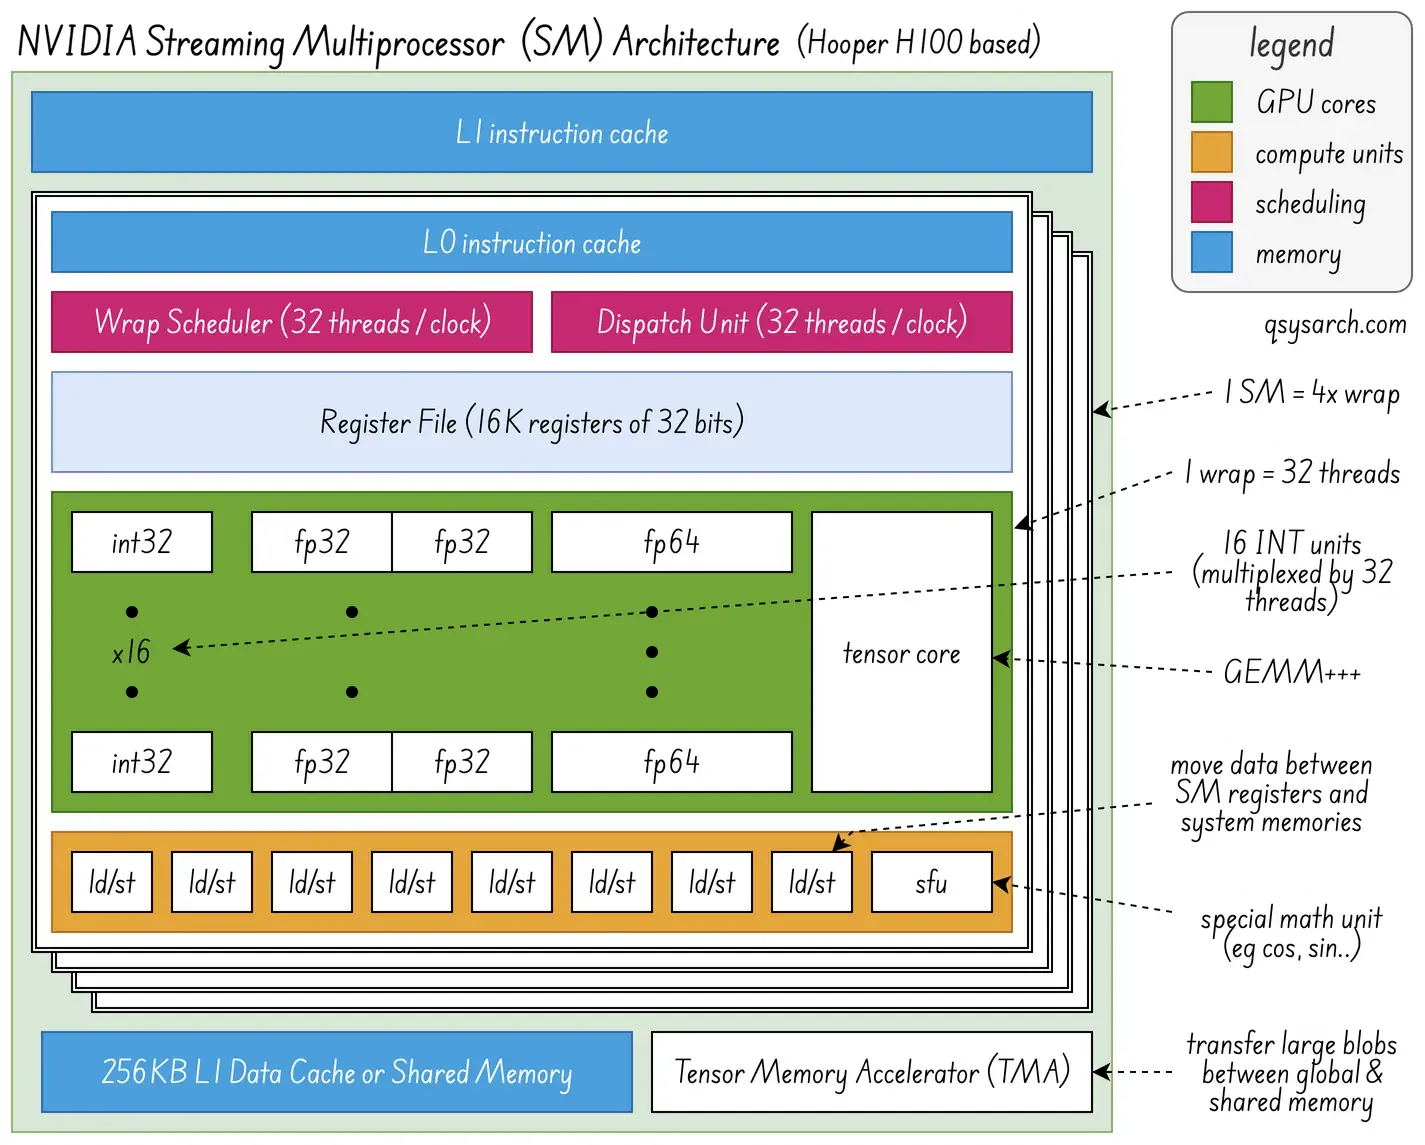
Um ein Gerät wie eine GPU zu programmieren, benötigen wir einen Befehlssatz. Im Fall von NVIDIA ist dieses Gerät der Streaming-Multiprozessor (SM), der im Diagramm rechts dargestellt ist. Interessant an diesem Diagramm ist, dass es viele parallele Einheiten gibt, wie z. B. die IN32-Addierer, die spezielle Funktionseinheit und den GEMM+++-Tensor-Kern. Der Compiler muss sicherstellen, dass diese Einheiten möglichst effizient (pipelined) verwendet werden, wobei Effizienz als Minimierung der Leerlaufzeit definiert ist.
Folgende Terminologie wird verwendet:
ISA (Befehlssatzarchitektur): Satz von Befehlen.
Maschinencode: Kompakte und binäre Darstellung der Anweisungen
Assemblersprache: weniger kompakte textuelle Darstellung der Anweisungen
Es gibt zwei ISAs für NVIDIA-GPUs:
PTX: Parallel Thread Execution - Zwischenassemblierung, die beim Kompilieren von Cuda-Kerneln verwendet wird.
SASS: Streaming Assembler. Low-Level-Assembler, spezifisch für jede GPU-Architektur.
Nehmen wir an, wir möchten diesen Kernel kompilieren:
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;

float vx = x[i], vy = y[i];
float len2 = vx*vx + vy*vy;
float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
z[i] = invLen; // Normalized length
}
Der Clou dabei ist, dass rsqrtf an die SFU-Pipeline weitergeleitet werden soll. Wie funktioniert das? Die Zeile _float invLen = rsqrtf(len2);_ wird in PTX als rsqrt.approx.ftz.f32 und anschließend in SASS als MUFU.RSQ konvertiert, wie in der Abbildung unten von [godbolt](https://godbolt.org/#g:!((g:!((g:!((h:codeEditor,i:(filename:'1',fontScale:14,fontUsePx:'0',j:1,lang:cuda,selection:(endColumn:2,endLineNumber:15,positionColumn:2,positionLineNumber:15,selectionStartColumn:2,selectionStartL)) dargestellt. ineNumber:15,startColumn:2,startLineNumber:15),source:’global+void+normalizeVector(float*+x,+float*+y,+float*+z,+int+n)%0A%7B%0A++++int+i+%3D+blockIdx.x++blockDim.x+%2B+threadIdx.x%3B%0A%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float +vy+%3D+y%5Bi%5D%3B%0A++++float+len2+%3D+vxvx+%2B+vyvy%3B%0A%0A++++//+Use+SFU+fast+reciprocal+square+root%0A++++flo at+invLen+%3D+rsqrtf(len2)%3B+%0A%0A++++//+Normalize+the+vector%0A++++x%5Bi%5D+%3D+vx++invLen%3B%0A++++y%5Bi%5D+%3D+ vy+*+invLen%3B%0A%7D’),l:‘5’,n:‘0’,o:‘CUDA+C%2B%2B+source+%231’,t:‘0’)),k:33.333333333333336,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:compiler,i:(compiler:nvcc130u2,filters:(b:‘0’,binary:‘1’,binaryObject:‘1’,commentOnly:‘0’,debugCalls:‘1’, demangle:‘0’,directives:‘0’,execute:‘1’,intel:‘0’,libraryCode:‘0’,trim:‘1’,verboseDemangling:‘0’),flagsViewOpen:‘1’,fontScale:14,fontUsePx:‘0’,j:1,lang:cuda,libs:!(),options:’-arch+sm_90+-use_fast_math+-O3’,overrides:!(),selection:(en dColumn:1,endLineNumber:1,positionColumn:1,positionLineNumber:1,selectionStartColumn:1,selectionStartLineNumber:1,startColumn:1,startLineNumber:1),source:1),l:‘5’,n:‘0’,o:’+NVCC+13.0.2+(Editor+%231)’,t:‘0’)),k:33.33333333333336,l:‘4’ ,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:device,i:(compilerName:‘NVCC+13.0.2’,device:‘SASS+(sm_90)’,editorid:1,fontScale:14,fontUsePx:‘0’,j:1,selection:(endColumn:6,endLineNumber:21,positionColumn:1,positionLineNumber:1,selectionStartColumn:6,s electionStartLineNumber:21,startColumn:1,startLineNumber:1),treeid:0),l:‘5’,n:‘0’,o:‘Device+Viewer+NVCC+13.0.2+(Editor+%231,+Compiler+%231)’,t:‘0’)),k:33.33333333333333,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’)),l:‘2’,n:‘0’,o:’’,t:‘0’)),version:4).
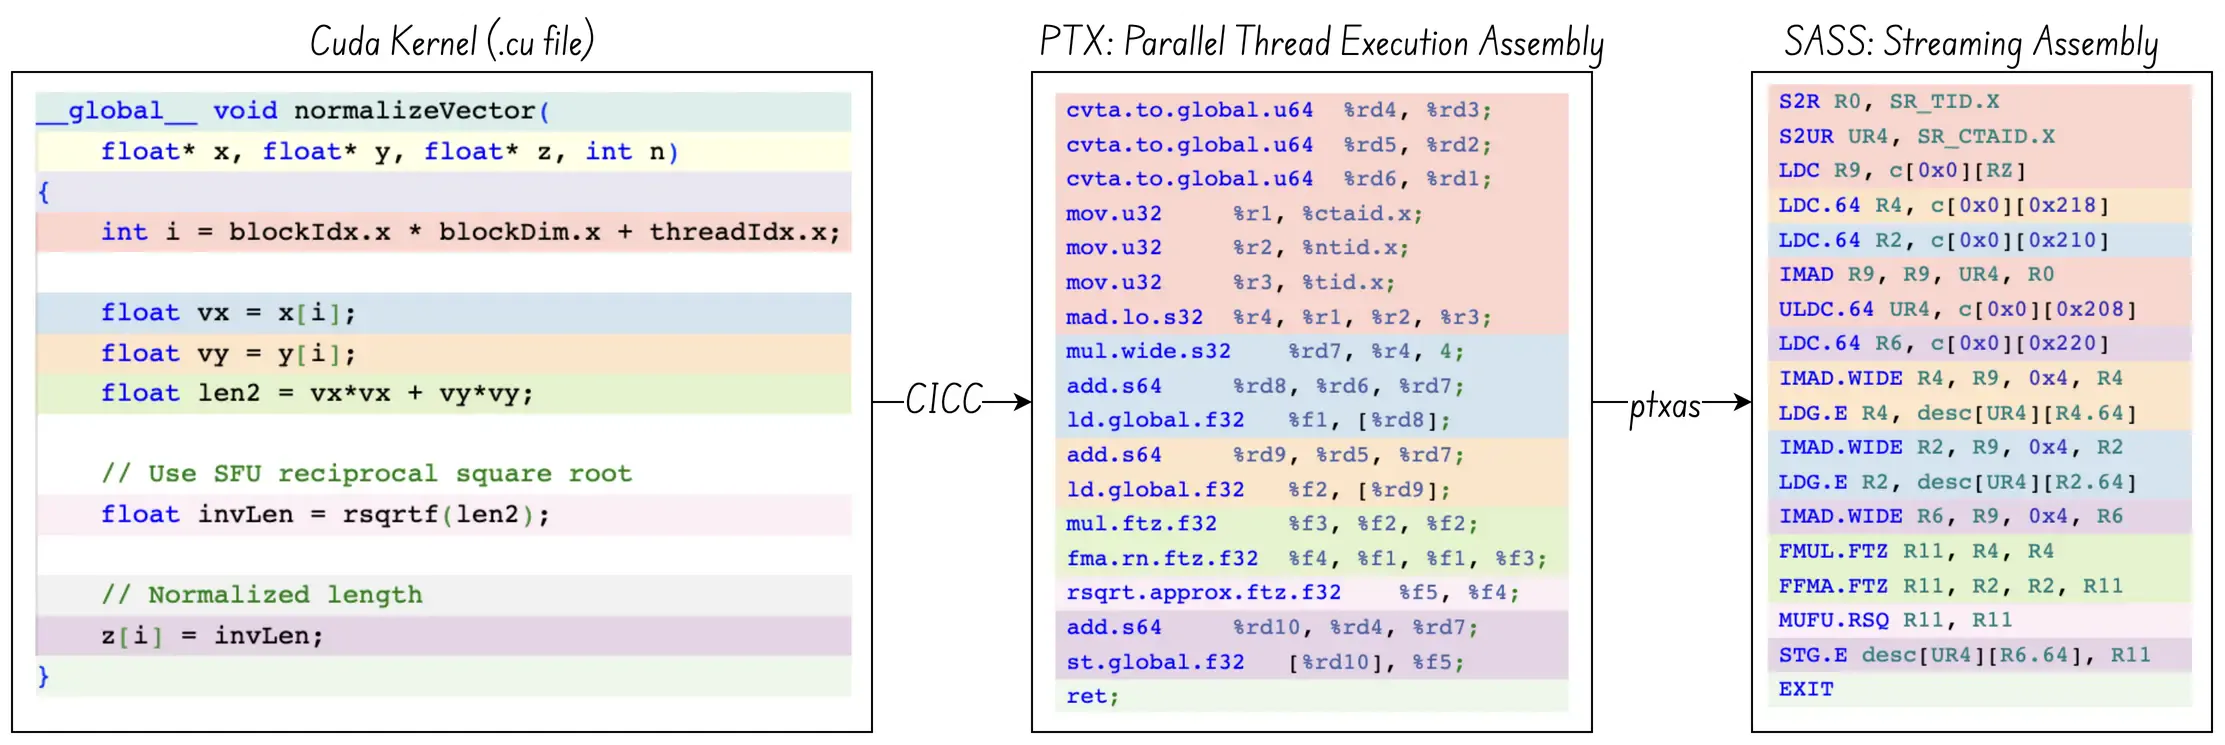
MUFU steht für Multifunktionseinheit, auch bekannt als SFU, die spezielle Funktionseinheit. MUFU.RSQ sendet das Register durch die Wurzelquadrat-Pipeline der SFU-Einheit. Es gibt viele andere Befehle im SASS-Assembler, wie z. B. FMUL (Fused Multiply) oder FFMA (Fused Multiply and Accumulate), die stattdessen an die Tensor-Kerneinheit weitergeleitet werden. Die Dispatch-Einheit ist dafür zuständig, die Befehle an die richtige Pipeline-Einheit zu senden.
Drei Dinge sind bemerkenswert:
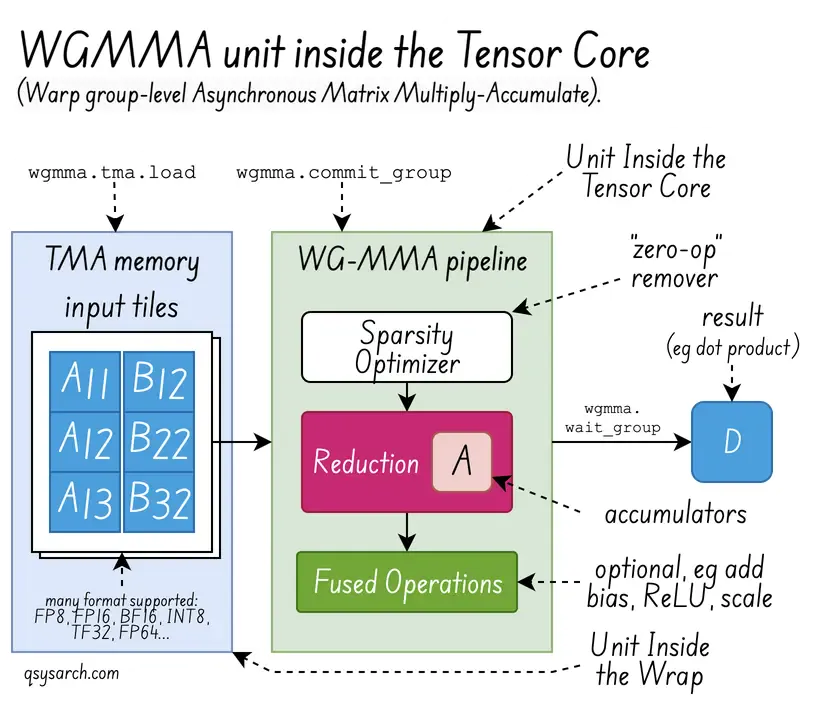
Der Tensor ist viel mehr als ein allgemeiner Matrixmultiplikator (GEMM): Er kann beispielsweise Reduktionsoperationen (Summe, Min/Max, Skalarprodukt) über eine MMA (Matrixmultiplikations-Akkumulations-)Einheit innerhalb des Tensorkerns durchführen.
Der Unterschied zwischen einer INT32-Einheit und einem Register: Die eine Einheit ist für die Berechnung zuständig (z. B. ADD, SHIFT, XOR, … oder allgemeiner für arithmetische Operationen, oder ALU), während die andere für die Speicherung von Werten zuständig ist.
Es gibt nur 16 INT32-Einheiten, aber 32 Threads. Dies ist kein Fehler: Der Warp-Scheduler wechselt in jedem Zyklus zwischen zwei Thread-Sets. In Zyklus 0 führen die Einheiten also ALU-Operationen für die Threads 0 bis 15 aus, und in Zyklus 1 für die Threads 16 bis 31.
Die asynchronen Warpgroup-Level-Matrix-Multiplikations-Akkumulationsbefehle (WGMMA) sind sehr leistungsstark. Weitere Informationen finden Sie in der NVIDIA-Dokumentation sowie im hervorragenden Blog von Aleksa Gordić.
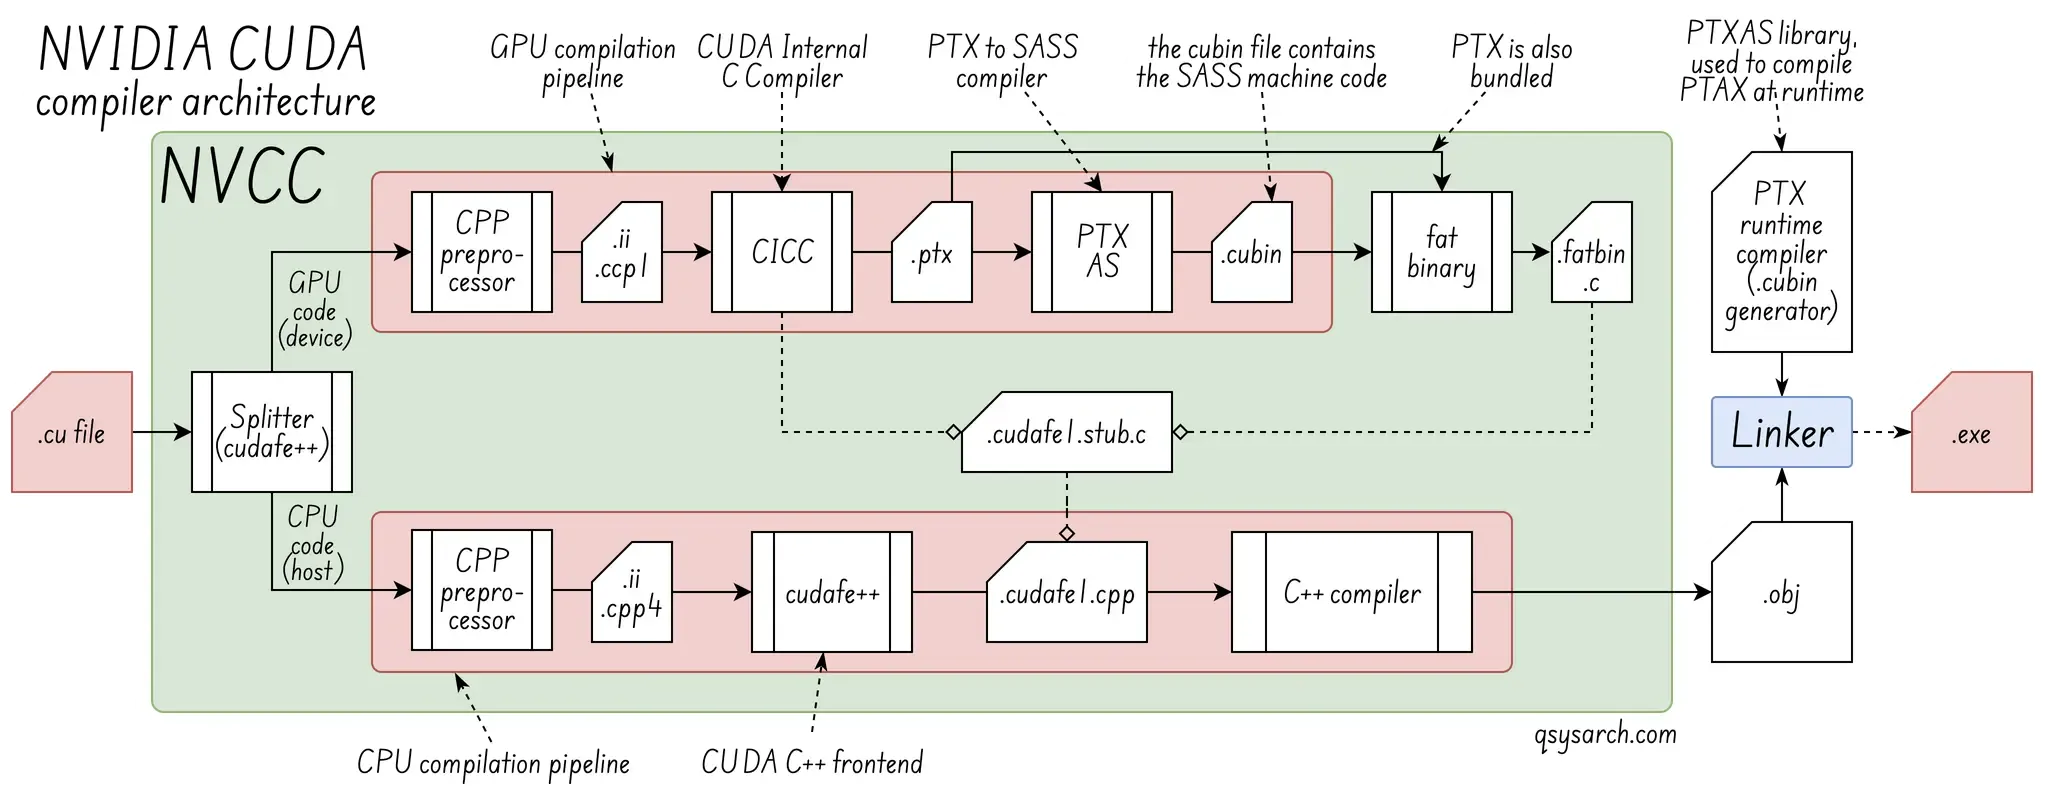
Nachdem wir nun etwas mehr über die Low-Level-ISA der GPU zur Programmierung des GPU-Streaming-Multiprozessors wissen, wollen wir uns ansehen, wie High-Level-C++-Kernel in SASS kompiliert werden. Wir wissen, dass der Compiler, der zur Konvertierung von CUDA-Kerneln (.cu-Dateien) in PTX verwendet wird, NVCC heißt.
Was ist also der Unterschied zwischen NVCC und LLVM? NVCC ist ein spezialisierter Compilertreiber, der die Open-Source-Compilerinfrastruktur von LLVM als Backend nutzt. LLVM hingegen ist ein flexibles Compiler-Framework und kein sofort einsatzbereiter Compiler wie NVCC.
Treiberprogramm: NVCC ist ein Treiber, der den Kompilierungsprozess von CUDA C/C++-Code verwaltet. Er trennt den Host-Code (CPU) vom Geräte-Code (GPU).
Toolchain: NVCC ist eine Toolchain, die einen Host-C++-Compiler (z. B. GCC/Clang unter Linux) für CPU-Code und einen NVIDIA-spezifischen internen Compiler (z. B. CICC) für GPU-Code (PTX & SASS) verwendet.
Fat Binaries: NVCC erzeugt typischerweise “Fat Binaries”, die sowohl die Host-Executable als auch den kompilierten GPU-Code enthalten, oft mit mehreren Versionen für verschiedene GPU-Architekturen.
Framework: LLVM ist eine Sammlung freier, offener, modularer und wiederverwendbarer Compiler-Technologien, Bibliotheken und Werkzeuge, die für den Aufbau einer breiten Palette von Compilern und Sprachwerkzeugketten entwickelt wurden.
Zwischenrepräsentation (IR): LLVM IR ist eine maschinenunabhängige “Mittelschicht”, die als universelles Bindeglied zwischen Frontends (C++, Go…) und ISA-Backends (x86, ARM…) fungiert.
Optimierung: Der LLVM-Optimierer wendet verschiedene Leistungsverbesserungen (wie Schleifenentrollung und Beseitigung von totem Code) auf die IR an, unabhängig von der Quellsprache oder der Zielarchitektur.
Es ist erwähnenswert, dass LLVM CUDA kompilieren kann: Das Clang-Frontend (Teil des LLVM-Projekts) kann CUDA-Code mit dem LLVM PTX-Backend verarbeiten, ohne dass der nvcc-Treiber erforderlich ist.
Die Triton-Sprache ist eine leistungsstarke, auf Python basierende domänenspezifische Sprache (DSL), die dazu dient, hochgradig vektorisierte Algorithmen zu erstellen, die zu effizientem parallelisiertem Code für GPU-Ziele kompiliert werden können.
Dies ist ein Beispiel für den einfachsten Kernel, der Daten aus einem Speicherblock lädt und in einen anderen schreibt. Der Wert von offsets ist [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]. Die Magie, die in diesem Codeausschnitt nicht gezeigt wird, besteht darin, dass Triton effizient mit dem Vektor v arbeiten kann, beispielsweise durch mathematische Operationen (siehe math).
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
v = tl.load(x_ptr + offsets)
tl.store(output_ptr + offsets, v)
Triton ist nicht auf 1D-Vektoren beschränkt und kann mithilfe von Tensoren auch mit mehr Dimensionen umgehen. Zum Beispiel:
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
M , N , # Number of rows and columns
BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
# X and Y tile position
pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
# Ptr in memory based on the stride
base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
# Offsets for X and Y indices
offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
# 2D loading ...that's magic!
loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
return loaded_2d_tensor
Im Vergleich zu CUDA kann Triton als Abstraktion höherer Ebene betrachtet werden, die speziell für die Erstellung von neuronalen Netzwerkkernen (dank des Tensorblock-Ansatzes) entwickelt wurde und effizienten vektorisierten und parallelen GPU-Code generieren kann. Triton unterstützt zudem mehrere Backend-GPUs.
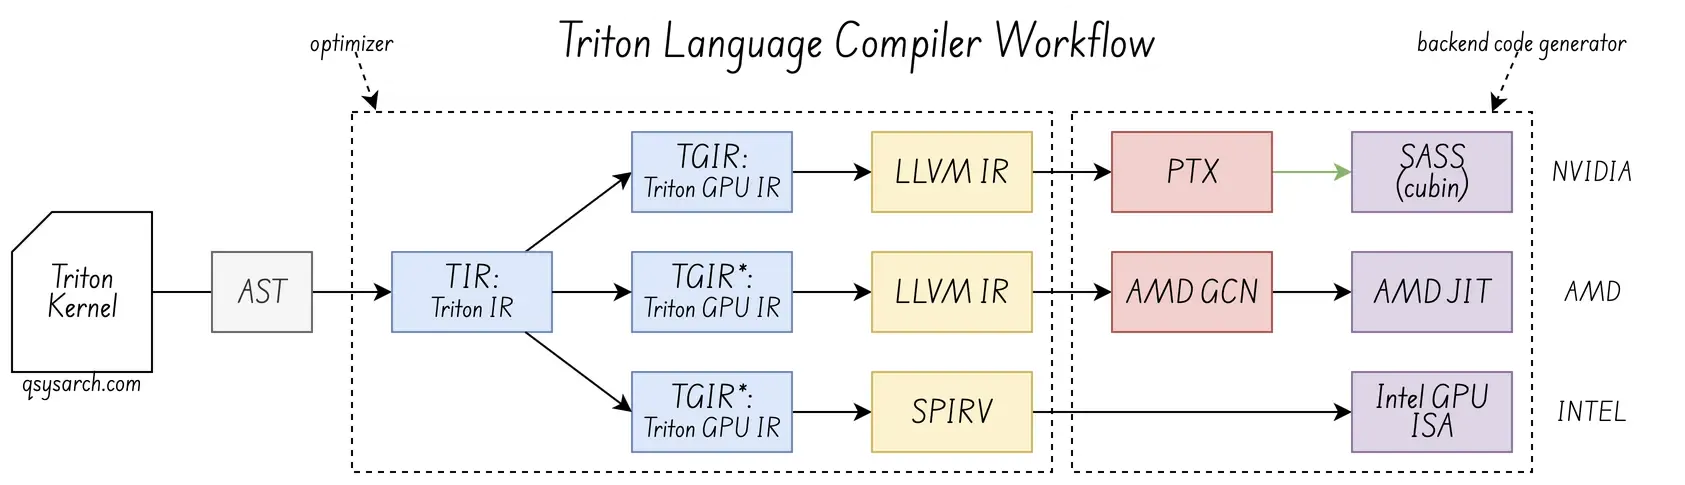
Triton verwendet keinen eigenen Sprachparser. Stattdessen greift es auf die Python-Laufzeitumgebung und den AST zurück und konvertiert diesen AST anschließend in seine eigenen Zwischenrepräsentationen TIR und TGIR, bevor es GPU-Code generiert. Die Verbindung zwischen dem CUDA-Backend-Compiler und dem Triton-Frontend-Compiler ist das universelle LLVMIR (https://mcyoung.xyz/2023/08/01/llvm-ir/), das für Intel-GPUs auf SPIRV (https://www.khronos.org/spirv/) basiert (wobei ich mir nicht sicher bin, ob TGIR direkt auf SPIRV heruntergerechnet wird, anstatt den Umweg über LLVMIR zu gehen).
Ich habe „vektorisierte Algorithmen“ geschrieben, obwohl das Kernkonzept eher auf gekachelte Blockmodelle ausgerichtet ist:
 . Das Kacheln ist der primäre Mechanismus. Tritons mentales Modell basiert auf der Programmierung von Operationen auf kleinen, statisch geformten mehrdimensionalen Teilarrays oder „Kacheln“, die der Compiler automatisch auf die GPU-Kerne parallelisiert.
Vektorisierung, also das Laden und Speichern mehrerer Datenelemente in einem einzigen Befehl, ist eine Optimierung: Der Compiler nutzt sie als wichtige interne Optimierungsstrategie, um diese Tiles effizient auf der zugrundeliegenden Hardware zu implementieren. Dieses Konzept deckt sich mit den verschachtelten Tiling-Strategien (siehe Abbildung rechts), die darauf abzielen, Tiles in Mikro-Tiles und schließlich Nano-Tiles zu zerlegen, um die Rechenleistung und Speicherhierarchie eines Rechners optimal auszunutzen.
Triton Language: Reduzierung der Stufen bis hin zur Streaming-Assemblierung
Link zu Überschrift
Schauen wir uns an, wie die High-Level-Anweisung tt.load der Triton-Sprache in SASS übersetzt wird. (Hinweis: Der folgende Code ist Pseudocode und funktioniert nicht direkt.)
Nach dem Parsen des Python-AST folgt als erste Stufe die maschinenunabhängige Triton-IR (TIR, ein MLIR-Dialekt). Auf dieser Ebene wird eine tt.load-Operation für eine Tile definiert. Diese tt.load-Operation ist eine nicht optimierte High-Level-Anweisung, die das Laden eines gesamten Tiles in den Speicher ausdrückt. Das Tile kann ein einzelnes Array, aber auch ein zweidimensionales Array oder sogar ein Array mit beliebigen Dimensionen sein.
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
Die High-Level-Operation tt.load auf einem Tensorzeiger und einem Datenblock (Tile). Der erste Eingabeparameter %ptrs ist ein Tensor (ein Array mit n Dimensionen), dargestellt durch tensor. <MxN, ptr >`. Es gibt einen Tensor der gleichen Dimension zurück, jedoch mit Werten anstelle von Zeigern auf Werte.
In der Praxis benötigt die Funktion tt.load außerdem einen Masken- und einen Standardwertparameter, der für das Lesen von den Speichergrenzen erforderlich ist (falls die Vektordimensionen nicht an der Schrittweite ausgerichtet sind).
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
Im nächsten Schritt wird die Triton-GPU-IR verwendet, um generische Tensor-Layouts in hardwarespezifische Layouts umzuwandeln, insbesondere hinsichtlich des Speicherlayouts und der Verteilung auf Threads und Warps. Anders ausgedrückt: TGIT wandelt die n-dimensionale Last in threadspezifische Vektorladeoperationen um, die sich leichter in LLVM implementieren lassen.
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
Die Triton-GPU-IR wird anschließend in threadspezifische Anweisungen umgewandelt, die in LLVM-IR dargestellt werden. Diese Low-Level-IR bildet die endgültigen Maschinenbefehle weitgehend ab und verwendet Standard-LLVM-Operationen wie Zeigerarithmetik, Speicherzugriffe und Synchronisierungsprimitive. Die Tensorabstraktion ist weitgehend verschwunden und wurde durch individuelle Speicherzugriffsoperationen für jeden Thread ersetzt.
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
Darstellung: Der Ladevorgang der Kachel wird in eine Reihe einzelner Ladeanweisungen mit Zeigerarithmetik für die spezifischen Datenelemente jedes Threads und gegebenenfalls shared-Speicheroperationen unterteilt, falls gemeinsam genutzter Speicher als Zwischenspeicher verwendet wurde.
Wenn das LLVM-Backend die NVIDIA-GPUs als Zielplattform verwendet, erfolgt der nächste Schritt: die Herabstufung auf PTX. Die LLVM-Ladebefehle werden direkt auf entsprechende PTX-Ladebefehle abgebildet.
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
Schließlich wandelt der NVIDIA-Treibercompiler (ptxas) den PTX-Assemblercode in SASS (Streaming Assembly) um, den eigentlichen nativen Maschinencode, der von den GPU-Kernen ausgeführt wird. Wie bereits erwähnt, erfolgt dieser Schritt üblicherweise Just-In-Time (JIT).
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
Bemerkenswert ist, dass CUDA eine sehr komfortable Methode zur Generierung von Maschinencode für NVIDIA-GPUs darstellt. Triton verwendet CUDA beim Downgrade von PTX auf SASS. Der Downgrade auf PTX erfolgt über LLVM IR, erfordert jedoch Bibliotheken des CUDA-Toolkits (z. B. libdevice.bc).
 DeepSeek verfolgte einen anderen Ansatz und entschied sich für die manuelle PTX-Optimierung: Benutzerdefinierte PTX-Kernel-Hilfsfunktionen wurden manuell geschrieben, wobei PTX als Assemblersprache für die GPU behandelt wurde. DeepSeek nutzte keinen Allzweckcompiler, um diesen spezifischen, stark nicht standardkonformen Code zu generieren. Triton hingegen, als generische Sprache, verwendet das Standard-LLVM-Compiler-Backend mit dem NVPTX-Ziel, um seine Zwischenrepräsentation (Triton-IR/MLIR) automatisch in optimierten PTX-Assemblercode zu übersetzen.
 DeepSeek-Wrapper in csrc/kernels/utils.cuh unter Verwendung der mbarrier.try_wait-Anweisung
Warum ist das wichtig? Aus dem technischen Bericht von DeepSeek (https://arxiv.org/html/2412.19437v1): „Wir (DeepSeek) verwenden speziell angepasste PTX-Befehle (Parallel Thread Execution) und optimieren die Größe der Kommunikationsblöcke automatisch. Dadurch wird die Nutzung des L2-Caches und die Beeinträchtigung anderer SMs deutlich reduziert.“ Bedeutet das, dass das LLVM-NVPTX-Backend nicht optimal effizient ist? Meiner Meinung nach bedeutet das, dass es noch Optimierungspotenzial gibt, nicht nur auf LLVM-Ebene, sondern auch durch die Bereitstellung einer besseren Bare-Metal-ISA (https://medium.com/prompt-engineering/deepseek-and-deepep-understanding-deep-seeks-custom-cuda-ptx-instruction-214d5408de6a)! Eine Win-Win-Situation!
Voilà, dieses Memo hat mal wieder länger gedauert als erwartet. Es handelt sich aber um eine dringend notwendige Vorstudie zur Einführung der Architektur von Cuda-Q. Ich werde diesen Beitrag aktualisieren, sobald er fertig ist.
 (Bildquelle: LLVM MOS)
In diesem Memo verwendete DrawIO-Diagramme: