Kürzlich stieß ich auf das Konzept des Kapazitäts- und Effizienz-Engineerings. Dabei handelt es sich um die Disziplin, Systeme optimal zu entwerfen und zu betreiben. Es ist ein zentraler Pfeiler der Systemarchitektur und besonders wichtig, wenn es auf Skalierbarkeit ankommt, wie beispielsweise bei Quantencomputersystemen.
Kapazitäts- und Effizienzplanung ist, vereinfacht gesagt, die Wissenschaft oder Disziplin der Produktionsoptimierung. Dies geschieht durch die Balance zwischen maximalem Output (Kapazität) und Ressourcenverbrauch (Effizienz).
Das Gute an Kapazitäts- und Effizienzplanung (CEE) ist, dass es sich um ein klar definiertes, in der Fachliteratur gut dokumentiertes und durch gut strukturierte Ingenieurpraktiken gestütztes Gebiet handelt. Dieses Memo versucht, einige Schlüsselkonzepte der CEE herauszuarbeiten.
Säulen der Kapazitäts- und Effizienzentwicklung
Link zu Überschrift
Capacity & Efficiency Engineering basiert auf drei Kernsäulen: Beobachtbarkeit, Modellierung und Planung.
Beobachtbarkeit
Modellieren
Planung
Das übergeordnete Ziel ist die Erstellung eines Plans, der sich mithilfe eines Modells effektiv simulieren lässt. Das Modell sollte anhand empirischer Beobachtungen validiert werden. Durch die Modellierung des Wachstums, die Identifizierung von Engpässen und die strategische Ressourcenallokation beugt der Plan Über- oder Unterauslastung vor und gewährleistet so einen optimalen Systembetrieb.
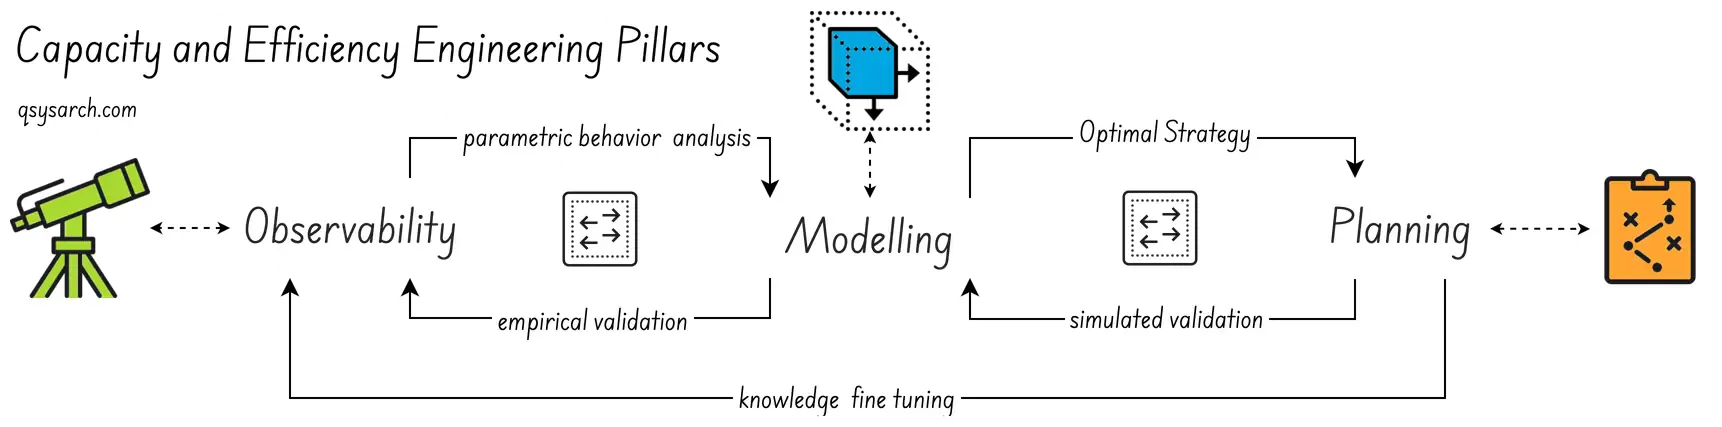
Es ist wichtig zu beachten, dass Systemressourcen alles Mögliche sein können. Das Spektrum reicht von IT-Ressourcen wie CPU oder Arbeitsspeicher bis hin zu Personal oder Maschinen. Tatsächlich lässt sich CEE in verschiedenen Bereichen anwenden. Beispielsweise kann es helfen, die Personaleinsatzplanung im Projektmanagement zu optimieren oder die Kosten für Cloud-Hosting im Infrastrukturmanagement zu senken.
Observability ist die empirische Analyse eines Systems. In Computersystemen werden Logs oft mit Observability verwechselt, sie sind aber nur ein Teil des Gesamtbildes. Der OpenTelemetry-Standard (https://opentelemetry.io/) umfasst beispielsweise mehrere beobachtbare Signale: Logs, Metriken, Traces und Baggage. Für CEE sollte effektive Observability Folgendes bieten:
Ressourcennutzung: Beobachtung und Nachverfolgung des Ressourcenverbrauchs. Die Beobachtung sollte angeben, was, wann und von wem die Ressource genutzt wird und ob Fehler aufgetreten sind.
Leistungskennzahlen: Wichtige Leistungsindikatoren (KPIs) wie Latenz und Durchsatz erfassen. Dazu gehören Ausbeute, Ausschuss und Fehlerraten.
Engpassidentifizierung: Ermittlung von Engpässen im System, die den Durchsatz beeinträchtigen.
Entscheidend ist die Fähigkeit, eine nachträgliche Analyse des Systems durchzuführen – und zwar unter allen Bedingungen, ob unter Volllast, während Wartungsarbeiten oder im Leerlauf. Es ist wichtig, detailliert zu verstehen, was wann und warum passiert ist. Ohne diese beobachtbaren Faktoren wäre es unmöglich, die Ursachen für Systemausfälle zu ermitteln.
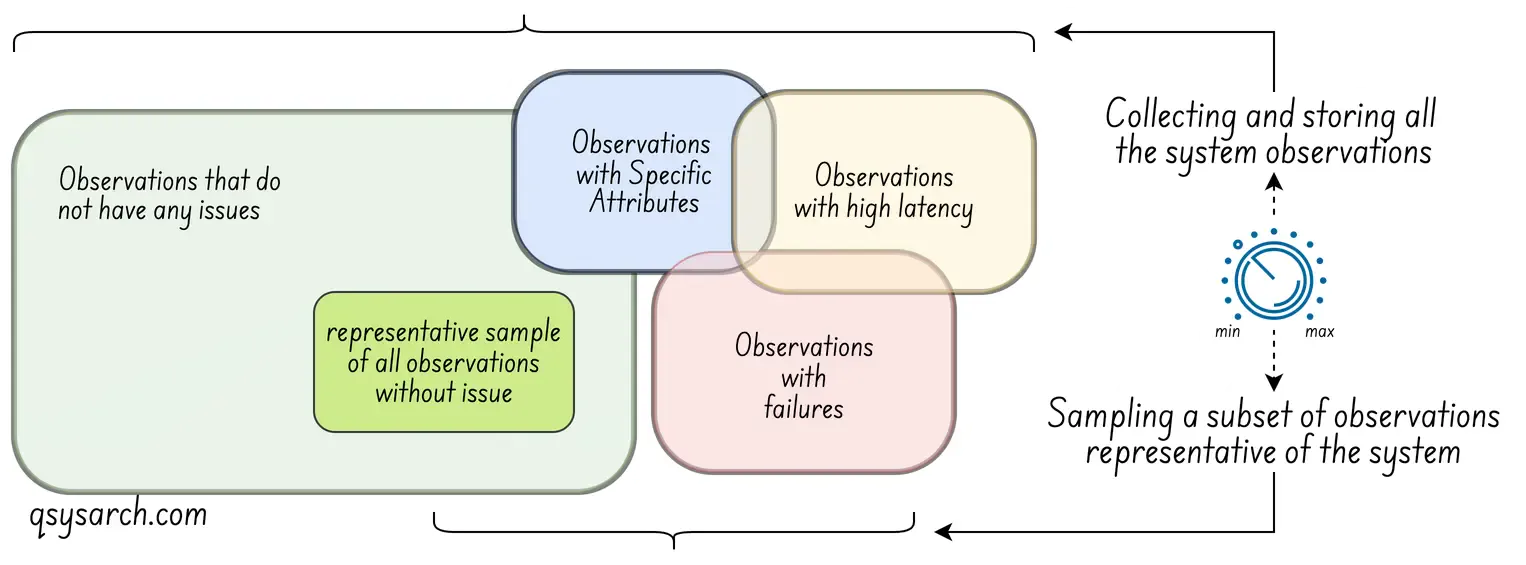
Die Erfassung aller Beobachtungsdaten eines kompletten Systems stellt natürlich eine Herausforderung dar: Beobachtungen können sehr kostspielig oder sogar destruktiv sein (wie beispielsweise beim Quantencomputing, wo die Messung eines Systems dessen Zustand verändern kann – ein Phänomen, das als Beobachtereffekt bekannt ist). Das bedeutet, dass allein die Beobachtung des Systems dessen Verhalten beeinflussen und seine Leistung beeinträchtigen kann. Die Lösung hierfür ist das Sampling (die Erfassung von Daten nur von ausgewählten Ereignissen anstatt von allen). Die Idee besteht darin, die Sampling-Rate (die Häufigkeit der Datenerfassung) zu einem einstellbaren Systemparameter zu machen, wie in der folgenden Abbildung dargestellt (Quelle: OpenTelemetry).
Bei einem System außerhalb der Informatik würde eine effektive Beobachtbarkeit beispielsweise die Erklärung für Projektverzögerungen ermöglichen. Die beobachtbaren Daten wären wahrscheinlich die gemäß ISO 9001 vorgeschriebenen technischen und nichttechnischen Dokumente, die die in jeder Projektphase getroffenen Entscheidungen nachvollziehbar dokumentieren.
Sobald die Beobachtbarkeit hergestellt ist, kann man beginnen, das analytische parametrische Verhalten des Systems zu verstehen. Dieses Verhalten bildet die Grundlage für den nächsten Schritt: Es lässt sich beschreiben und in ein parametrisches Modell übersetzen. Im nächsten Schritt gilt es zu klären, was ein solches Modell bei gegebenen Parametern oder Bedingungen leisten muss.
Leistung: Welchen maximalen Durchsatz und welche maximale Latenz kann das System bieten?
Betriebskosten: Wie hoch sind die Betriebskosten des Systems, gemessen an der Anzahl der zugewiesenen Ressourcen? Diese Kosten können je nach Tageszeit variieren.
Neukonfiguration: Welche vorübergehenden Auswirkungen hat die Aktualisierung der Systemparameter? Zum Beispiel bei der Zuweisung eines neuen Servers oder einer neuen QPU und deren korrekter Konfiguration.
Entscheidend ist die Simulation des Systemverhaltens und die Beobachtung seiner Leistung unter verschiedenen Betriebsbedingungen. Da das Modell Ressourcenkosten berücksichtigt, lassen sich unter diesen Bedingungen Kosten-Nutzen-Abwägungen aufzeigen. Diese Informationen sind für die Planungsphase wichtig.
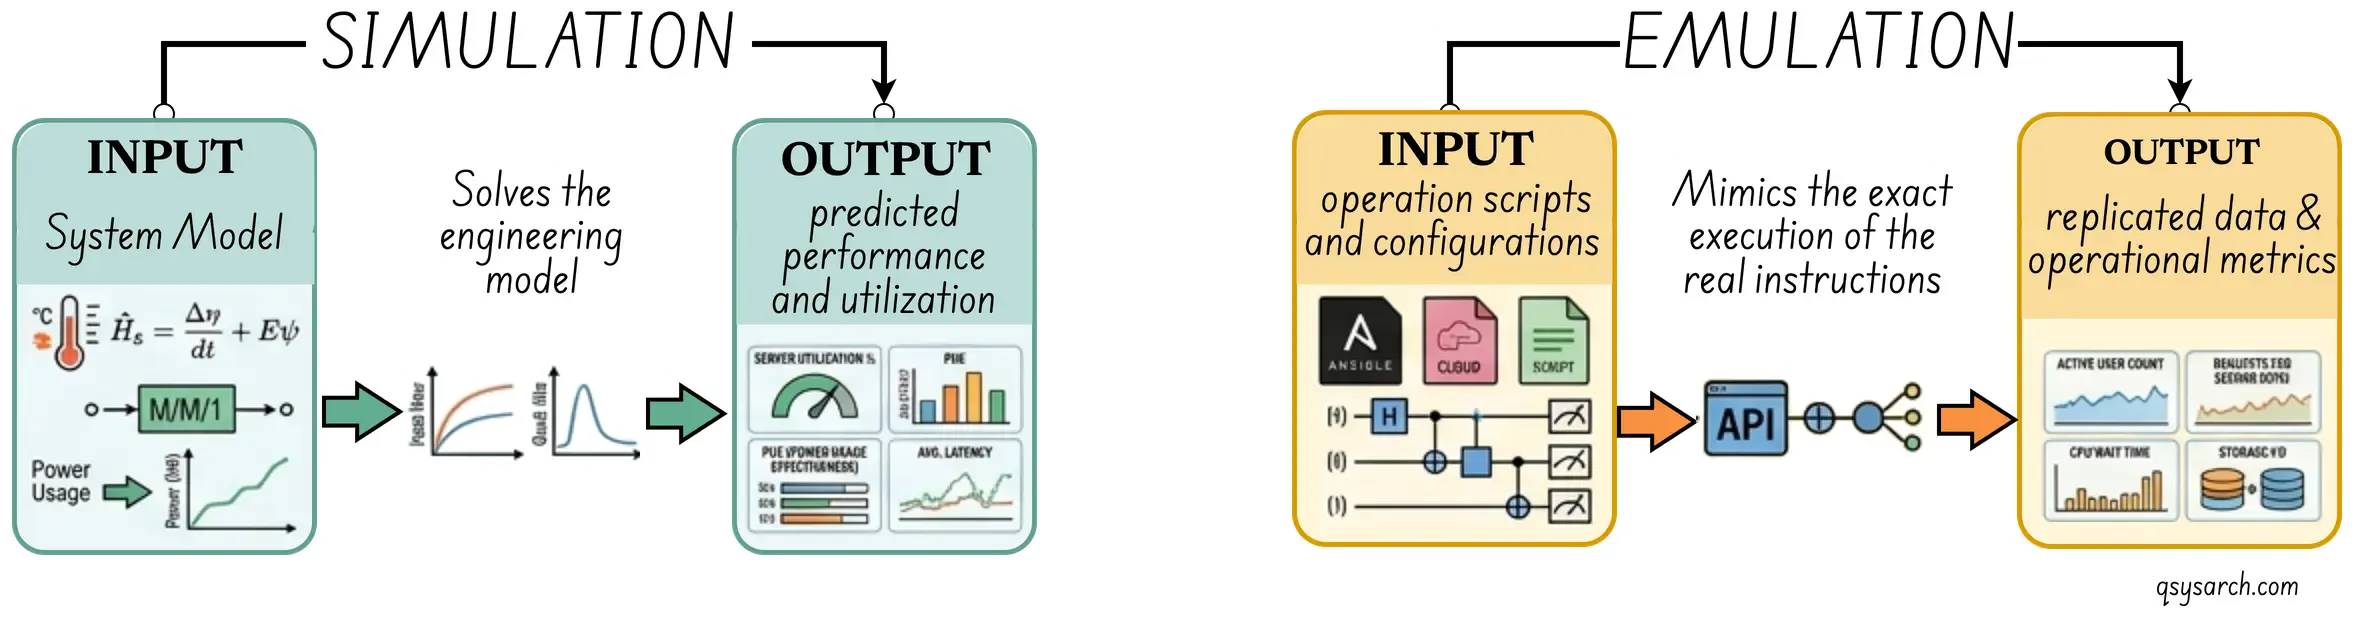
An dieser Stelle sei der Unterschied zwischen Simulation und Emulation erläutert. Vereinfacht gesagt, erstellt die Emulation eine nachgebildete Version des Systems, während die Simulation mit einem abstrakten Modell des Systems arbeitet. Bei der Emulation ist es möglich, die emulierte Leistung mit der realen Leistung zu vergleichen, da die Eingaben identisch sind. Ich gehe davon aus, dass im Kontext von CEE der Begriff „Modell“ meist einen Simulator meint.
Ein gutes Modell für ein nicht-computergestütztes System könnte die Auswirkungen der Hinzufügung weiterer Ressourcen zu einem Projekt vorhersagen. Tatsächlich kann die Hinzufügung von Ressourcen die Systemleistung manchmal sogar verringern. Dieses kontraintuitive Ergebnis ist als Brooks’sches Gesetz bekannt.
Mit dem Modell können Sie nun die Systemabläufe planen. Simulieren Sie mithilfe des Modells verschiedene Szenarien und ermitteln Sie die optimalen. Nutzen Sie diese Ergebnisse, um Ressourcen strategisch dem Bedarf zuzuweisen. Ein guter Plan sollte Bedarfsprognosen, Kostenmanagement und Ausfallsicherungen beinhalten. Prognosen sagen zukünftige Nutzung, Verkehrsaufkommen oder Bedarfe voraus. Das Kostenmanagement verhindert Überdimensionierung und gewährleistet gleichzeitig die Kapazität für Spitzenzeiten. Ausfallsicherungen bieten Puffer, um unerwartete Bedarfsspitzen abzufangen.
Entscheidend ist ein effizienter und zuverlässiger Systembetrieb. Lastspitzen müssen ausfallsicher bewältigt werden. Kosteneffizienz muss gewährleistet sein. Prognostizierte Kapazität ermöglicht eine vorausschauende Umkonfiguration. Ein ausreichender Puffer für unerwartete Ereignisse muss vorhanden sein.
Der Plan kombiniert das Best-Case-Szenario, in dem die Nachfrage den Erwartungen entspricht, mit dem Worst-Case-Szenario, in dem die Nachfrage höher oder niedriger als erwartet ausfällt. Dieser Ansatz ermöglicht eine kostenoptimale Kapazitätsverteilung.
Die Entwicklung eines guten Modells ist ein Henne-Ei-Problem. Solange man nicht weiß, was und wie man es im System beobachten soll, ist es schwierig, ein effizientes und präzises Modell zu erstellen. Ohne ein präzises Modell wird der Plan wahrscheinlich keine guten Ergebnisse liefern.
Treten Abweichungen zwischen dem simulierten Plan und dem tatsächlichen Verhalten auf, versucht man, die fehlenden Parameter zu ermitteln. Dies geschieht üblicherweise durch die nachträgliche Analyse von Protokollen des beobachteten Systems. Ziel ist es, neue zu beobachtende Parameter zu identifizieren.
Dieser Lernprozess wird im obigen Diagramm als Wissensfeinabstimmung dargestellt.
CEE allein wäre ohne eine automatisierte Plattform, die den gesamten Workflow unterstützt, nicht ausreichend. Diese Engineering-Plattform ist im folgenden Diagramm dargestellt.
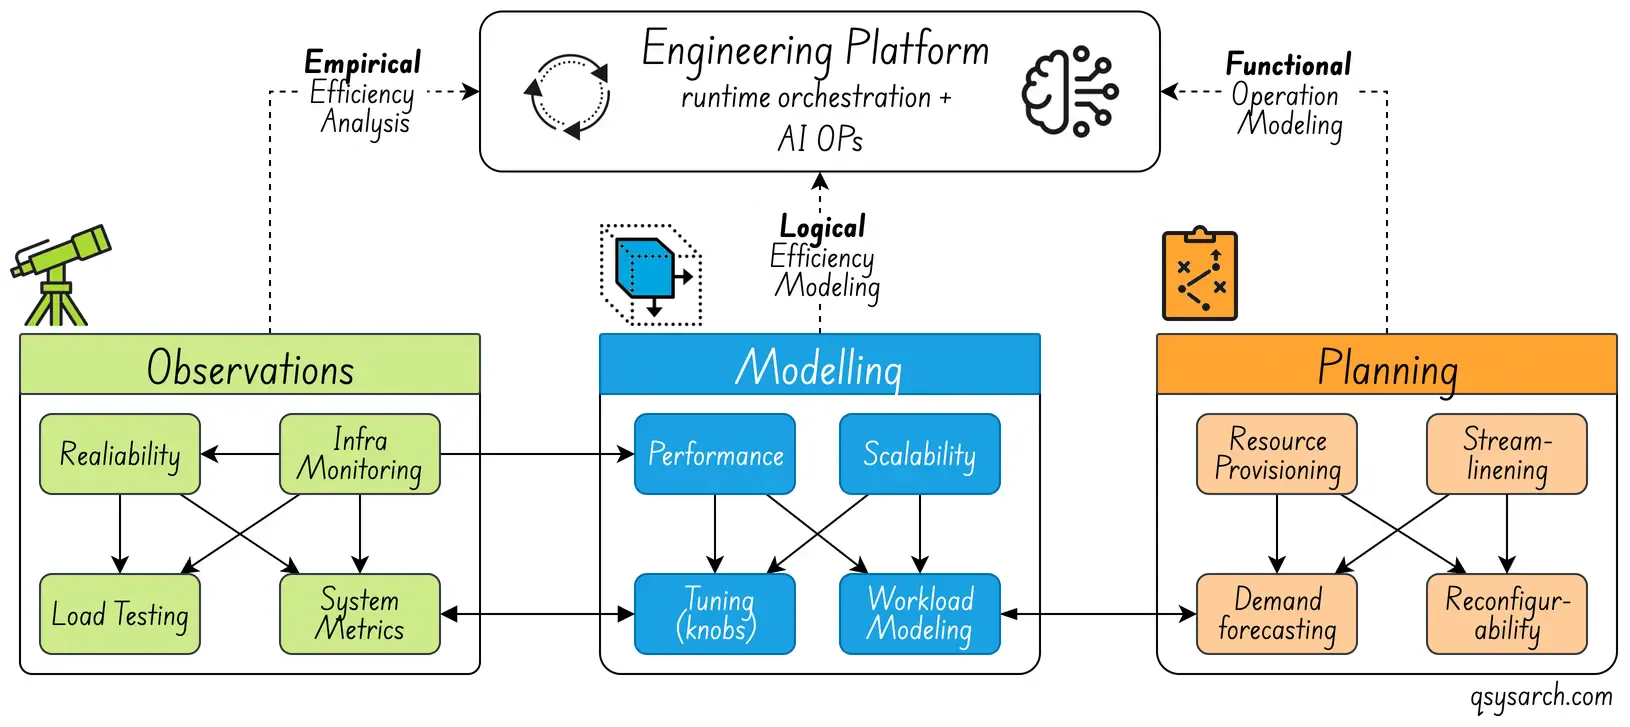
Die Engineering-Plattform dient nicht nur der Automatisierung der Systemskalierung, die an AIOps-Agenten delegiert werden kann. Sie überprüft kontinuierlich die Eignung des simulierten Modells anhand empirischer Beobachtungen und meldet Abweichungen an einen ML-Agenten zur Feinabstimmung des Modells. Dieser Agent basiert wahrscheinlich auf Reinforcement Learning und sollte bei Echtzeitnutzung reguliert werden.
Die Kosten, die entstehen, wenn man nicht schnell genug skaliert, auch bekannt als die Kosten der Verzögerung.
Link zu Überschrift
Damit ein System stabil und robust ist, sollte seine Leistung auf einem stabilen Niveau und nicht auf dem Maximalwert begrenzt werden. Als Faustregel gilt: Eine stabile Leistung liegt bei etwa zwei Dritteln der maximalen Leistung. Jenseits dieser Schwelle verschlechtert sich die Systemleistung. Die Kosten von Ausfallzeiten können dann schnell – oft exponentiell – die Kosten einer Überdimensionierung übersteigen.
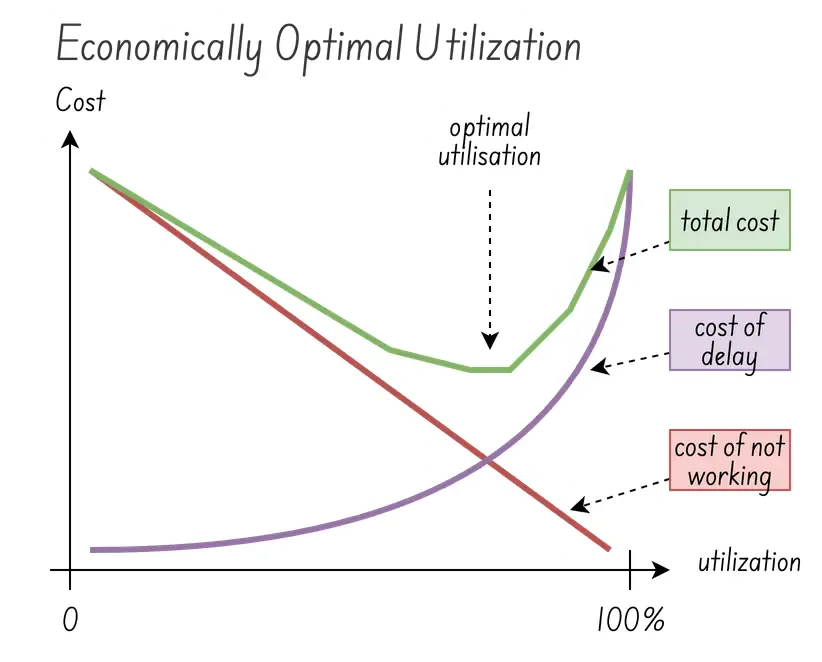
Im Bild rechts lassen sich die Kosten der Verzögerung als die finanziellen Auswirkungen betrachten, die entstehen, wenn die Nachfrage während der (Echtzeit-)Skalierung des Systems nicht bedient werden kann. Es handelt sich hierbei um vorübergehende Kosten. Bei geringer Auslastung betrifft die Verzögerung nur wenige Anfragen. Bei hoher Auslastung hingegen betrifft sie viele Anfragen, und die Kosten der Verzögerung steigen exponentiell an.
Der optimale Auslastungsgrad minimiert sowohl die Kosten durch Verzögerungen als auch die Kosten durch Nichtbetrieb (Überdimensionierung). Die grüne Kurve zeigt die Gesamtkosten als Summe dieser beiden Faktoren. Das lokale Minimum dieser Kurve, üblicherweise bei etwa zwei Dritteln der maximalen Leistung, markiert die optimale Auslastung. Es gäbe noch viel mehr über den optimalen Auslastungsgrad zu sagen, der – wie manche argumentieren werden – bei etwa 80 % liegt. Entscheidend ist die Erkenntnis, dass die Reduzierung der Verzögerungskosten durch Systemoptimierung eine Anhebung der optimalen Auslastung ermöglicht (Bildnachweis: show me the data).
Wenn die Senkung der Ausfallkosten eines Systems die Skalierungszeit verkürzt, stellen Sie sich ein System vor, das sich innerhalb von Millisekunden oder sogar Mikrosekunden an die steigende Nachfrage anpassen kann. Die Entwicklung eines solchen Systems kann natürlich sehr kostspielig sein (man denke an Hochfrequenzhandel). Was aber, wenn die Entwicklungskosten geringer wären als der Nutzen einer höheren Systemauslastung?
Diese Herausforderung ist ebenfalls Teil der Kosten-Nutzen-Analyse. Durch die Modellierung der Kosten für Systemverbesserungen lässt sich ein Plan erstellen, der Kosten und Nutzen der Verbesserung in Einklang bringt. Es handelt sich weniger um eine operative Herausforderung als vielmehr um eine strategische Investition. Dennoch basiert sie auf denselben Prinzipien der Kosten-Nutzen-Analyse, die auch für die operative Strategie des Unternehmens als System gelten.
Die Wertstromanalyse (Value Stream Mapping, VSM) wird im Kontext der Kapazitäts- und Effizienzplanung häufig als Diagnoseinstrument eingesetzt, um festzustellen, wo Kapazität verbraucht wird. Dies ermöglicht die Identifizierung der Hauptursachen von Verschwendung und Engpässen.
Ein Wertstrom umfasst alle Schritte bzw. Aktivitäten im Arbeitsablauf, die das System zur Erbringung einer Dienstleistung nutzt. Die Wertstromanalyse (VSM) stellt diesen durchgängigen Ablauf visuell dar. Die VSM unterscheidet drei Arten von Aktivitäten:
Wertschöpfung (VA): Schritte, die direkt zum vom Kunden gewünschten Ergebnis beitragen (z. B. die eigentliche Berechnung).
Nicht wertschöpfend, aber notwendig (NNVA): Schritte, die vom System benötigt werden, aber keinen direkten Kundennutzen bringen (z. B. Handshakes).
Verschwendung (Muda oder 無駄, ein japanischer Begriff, der “Verschwendung” bedeutet): Schritte, die Kapazität verbrauchen, ohne einen Mehrwert zu schaffen.
Ziel ist es, Verschwendung (Muda-Schritte) zu eliminieren, und die Wertstromanalyse (VSM) eignet sich hervorragend, diese zu identifizieren. Die Stärke der VSM liegt in ihrer Fähigkeit, die richtigen Optimierungen zu finden, die den laufenden Betrieb (Work in Progress, WIP) reduzieren. Dies ist aufgrund des Little’schen Gesetzes (Little’s Law) wichtig, das besagt, dass die durchschnittliche Durchlaufzeit (oder Zykluszeit) gleich dem durchschnittlichen laufenden Betrieb (WIP) geteilt durch den durchschnittlichen Durchsatz ist.
Lieferzeit = Unfertige Erzeugnisse / DurchsatzDas bedeutet, dass sich bei einer Verdopplung des WIP (Work in Progress) auch die Durchlaufzeit verdoppelt, selbst bei gleichbleibendem Durchsatz. Die Kontrolle des WIP ist daher einer der direktesten Hebel zur Verbesserung der Lieferlatenz (der „Verzögerung“) und somit der Systemeffizienz.
Voilà, dieses kurze Memo zum Thema Kapazitäts- und Effizienzoptimierung (CEE) am Sonntagmorgen hat mir geholfen, das Thema besser zu verstehen. Fürs Erste möchte ich mir merken: Wenn ein System eine sehr geringe Effizienz aufweist, ist dies höchstwahrscheinlich ein Zeichen dafür, dass das System oder seine Arbeitsabläufe mit Verschwendung (Muda) überlastet sind. Die Lösung für diese Herausforderung: In die Reduzierung der Verzögerungskosten investieren, anstatt durch Überdimensionierung?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |