xPU: Dies ist ein Oberbegriff für eine spezialisierte Verarbeitungseinheit (PU), wobei „x“ für jede für eine bestimmte Arbeitslast angepasste Rechenarchitektur stehen kann. Gängige Varianten sind GPUs (Grafik), TPUs (Tensor/KI), NPUs (neuronale Netze), DPUs (Daten) oder PPUs (Pulsprozessoren, hauptsächlich für Quantenkontrollsysteme).
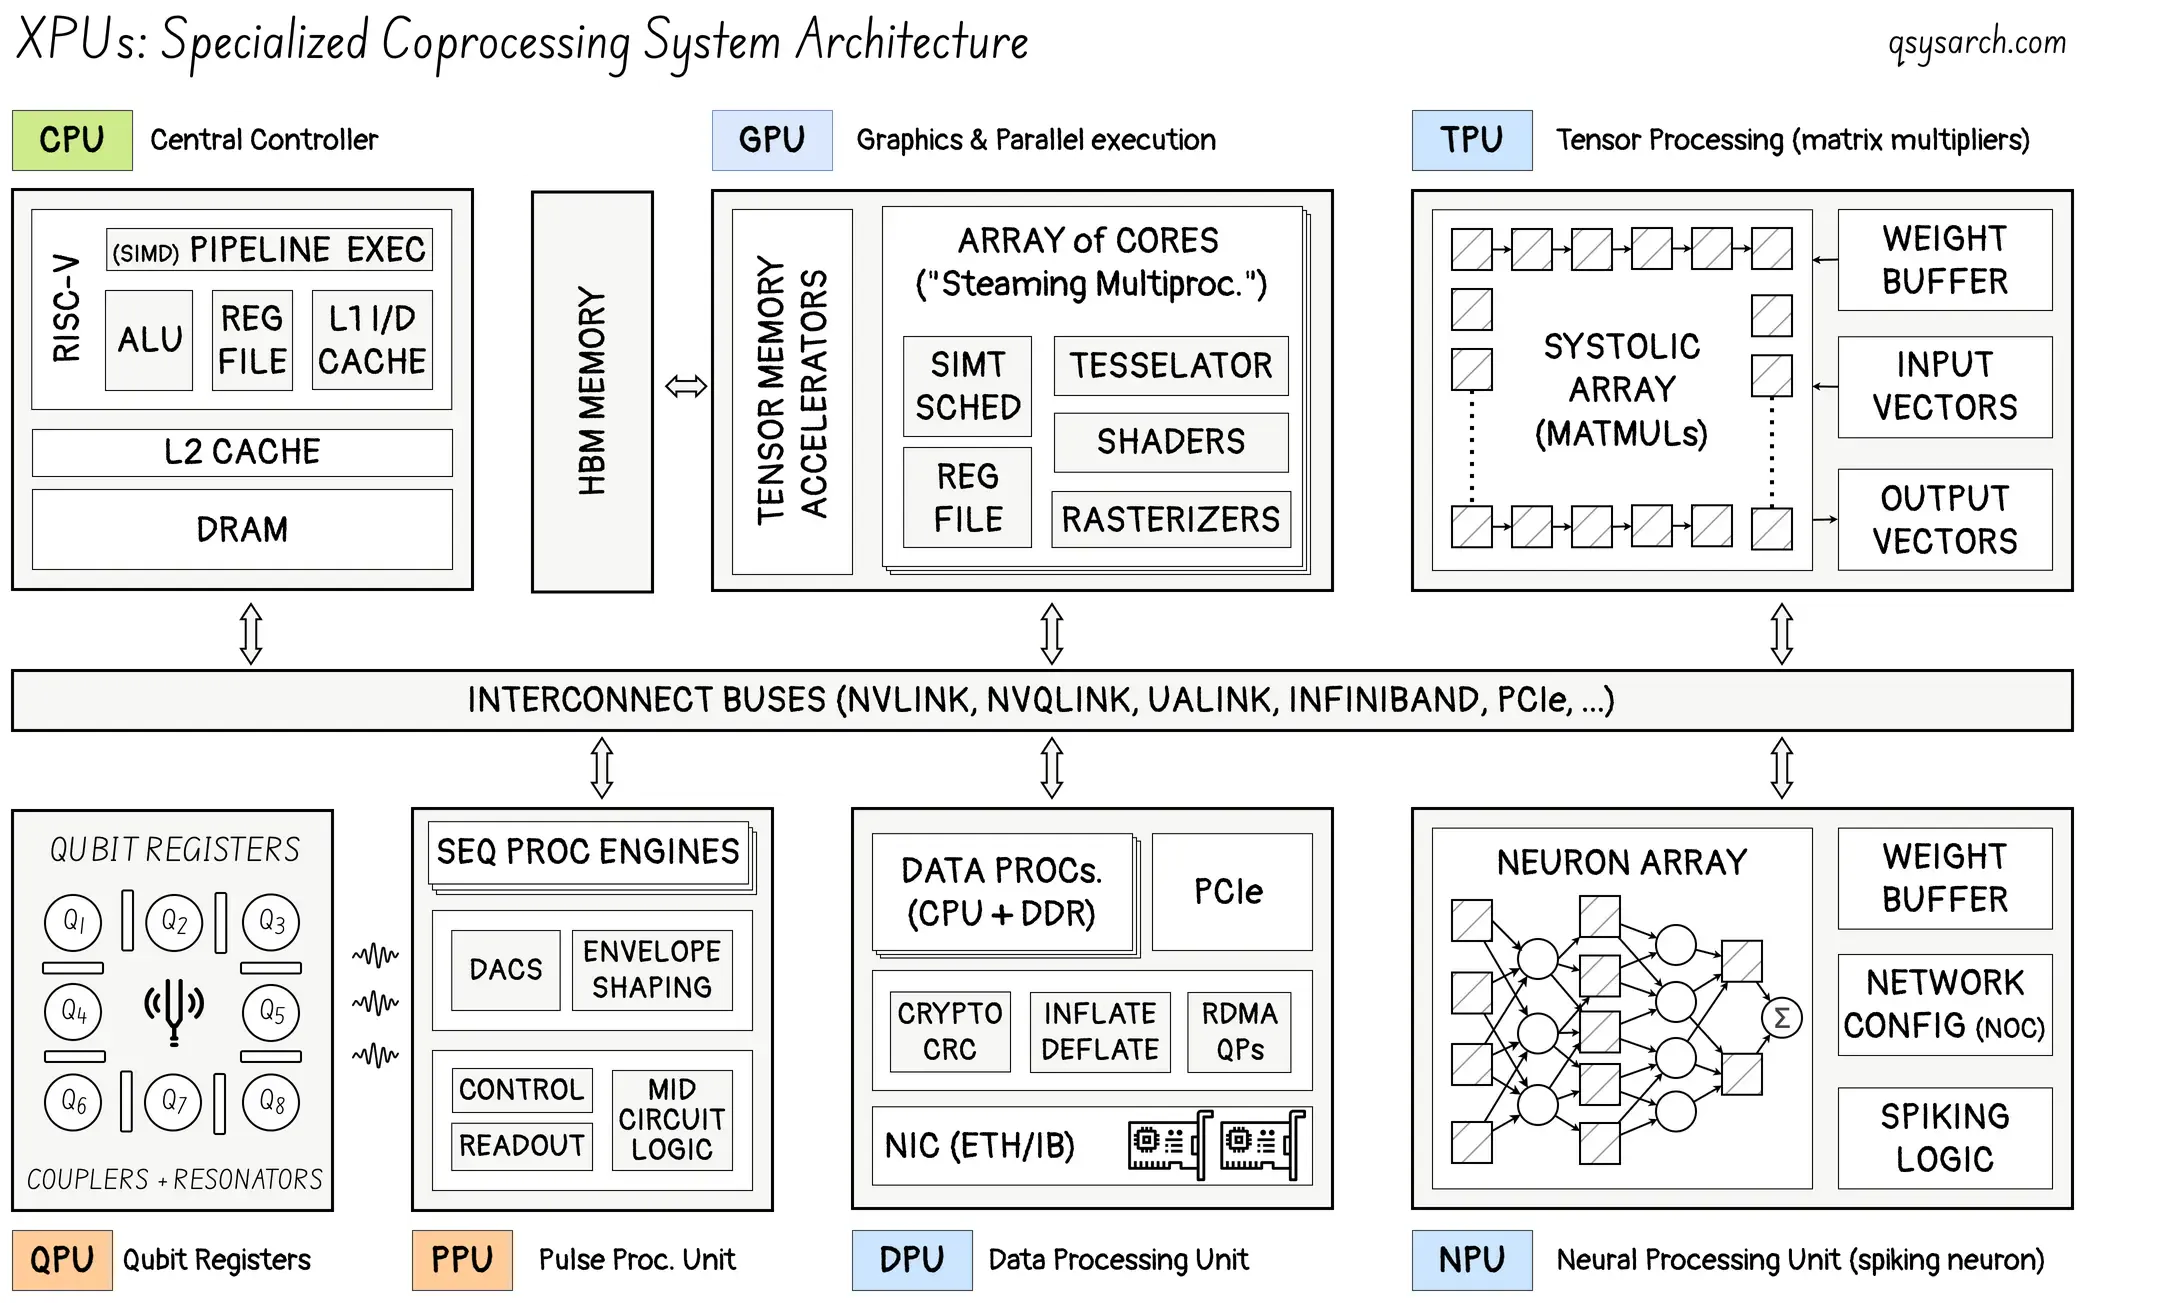
Dieses superkurze Memo soll Einblicke in die Marktlandschaft von xPU im Kontext von KI-Inferenz geben.
Bei der Betrachtung des Marktumfelds für KI-Inferenz-ASICs ist die aussagekräftigste Kennzahl möglicherweise nicht die reine Leistung, sondern die Frage, ob sich die Alleinstellungsmerkmale eines Anbieters über einen Zeitraum von drei bis fünf Jahren behaupten lassen. Aus dieser Perspektive lassen sich drei Cluster herauskristallisieren:
Die universelle Plattform: NVIDIA und die vertikalen Integratoren: AMD, Google
die aktuellen Herausforderer Groq, Cerebras, FuriosaAI, Positron, SambaNova, Axelera AI.
Die zukünftigen Herausforderungen: Extropic, Normal Computing, Unconvential, Mottronix, Akhetonics
NVIDIA
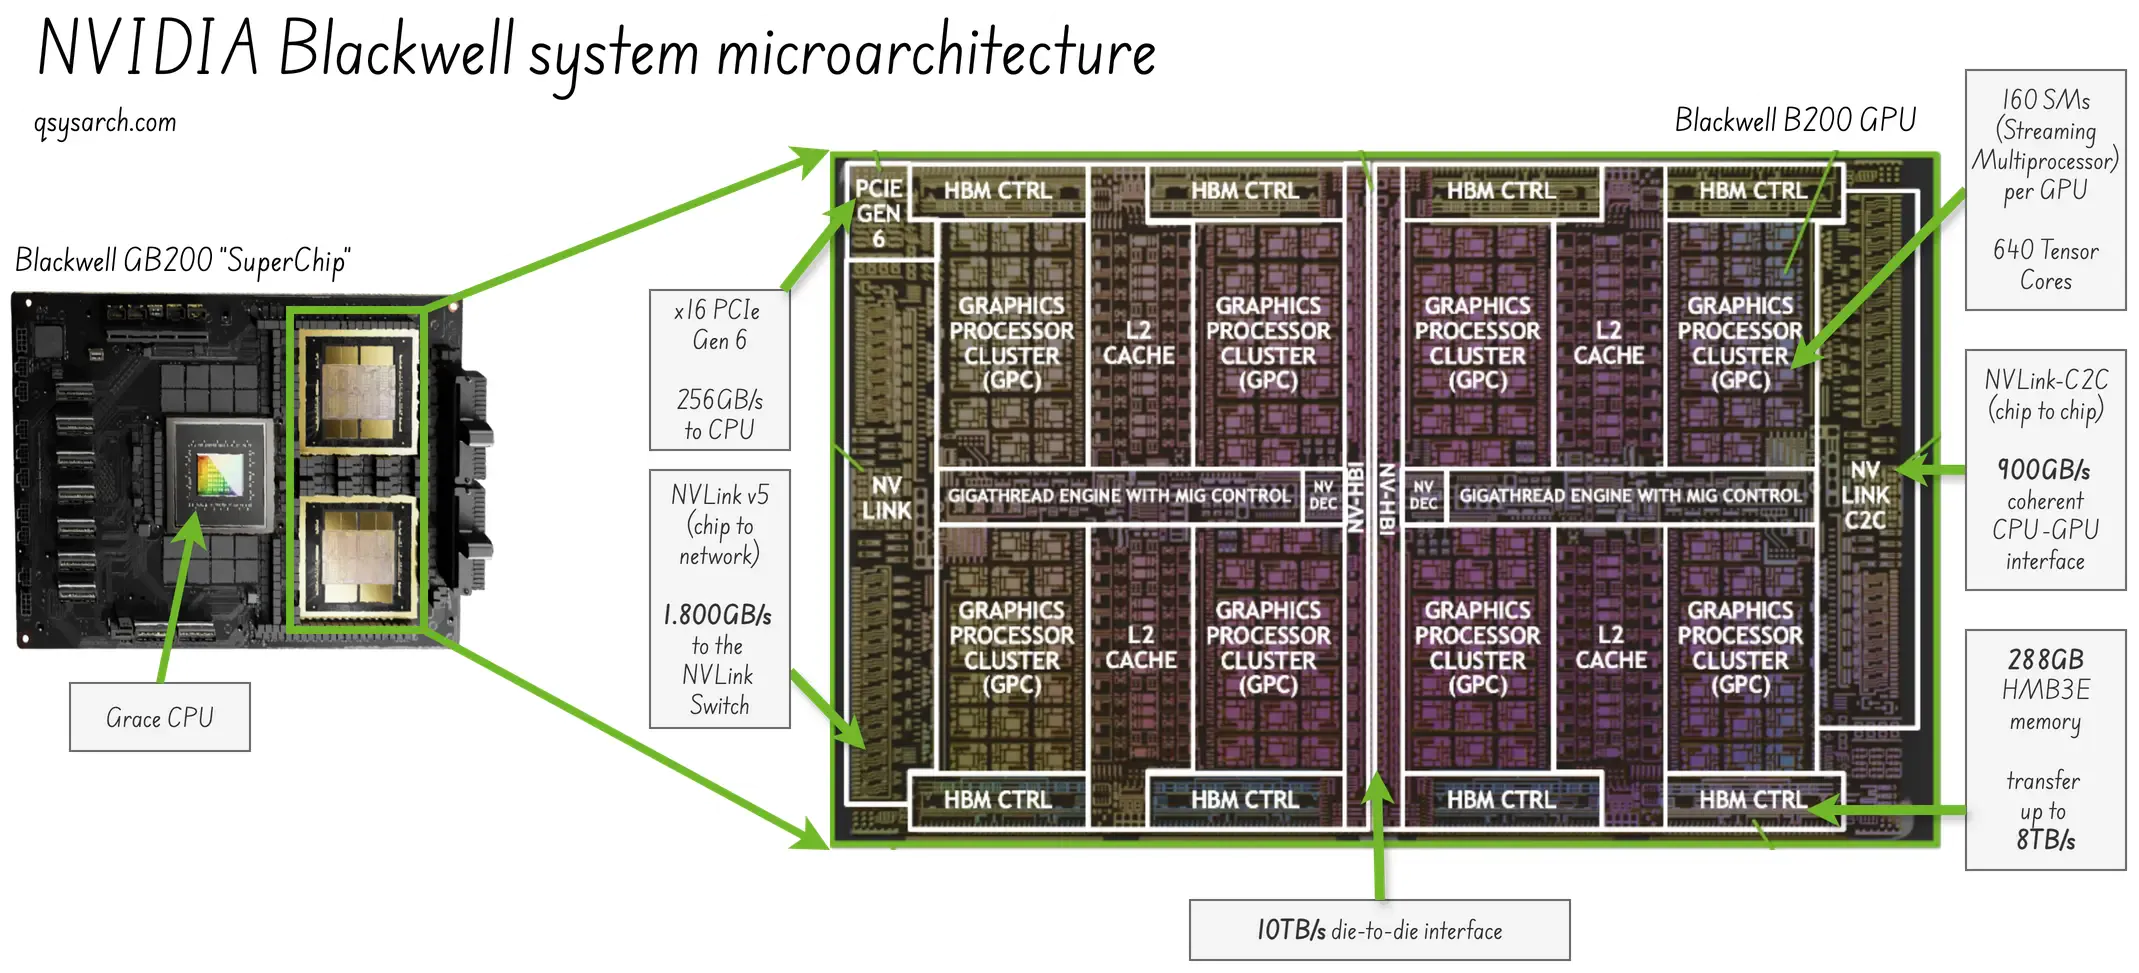
Architektur: GPU (Blackwell-Architektur im Jahr 2024)
Kernstärke: Ökosystembindung, Tiefe des Software-Stacks, vollständige Systemintegration
Ziel-Workload: Universell – LLM-Training und -Inferenz im großen Maßstab – Grafik-Shader
Schwachstelle: Hohe Kosten, hoher Stromverbrauch; Nicht optimiert für spärliche Rechenprozesse
Google
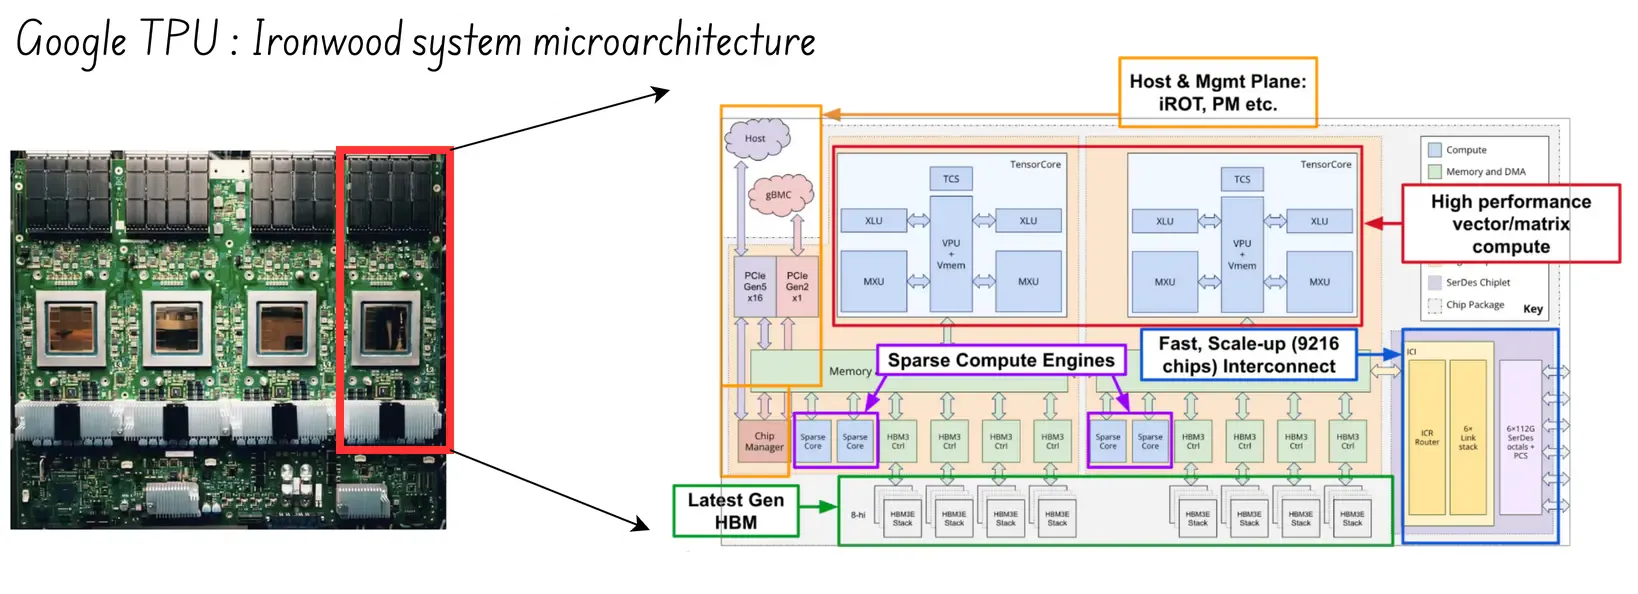
Architektur: TPU, kundenspezifischer ASIC (systolisch)
Kernstärke: Vertikale Integration; niedrigste Kosten im Google-Maßstab
Ziel-Workload: Google Cloud-Workloads, Gemini-Inferenz
Schwachstelle: Nur über die Google Cloud verfügbar; TPU-Kerne können nicht von Google erworben werden.
AMD
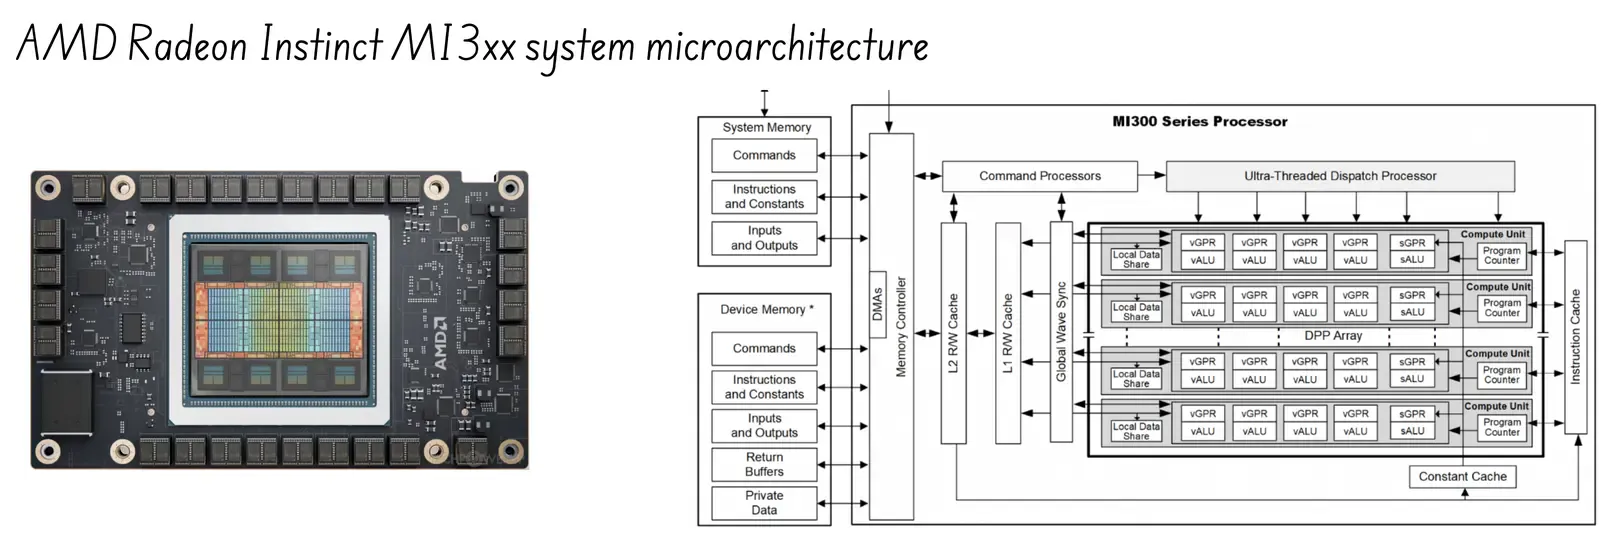
Architektur: MI300 Instinct + ROCm (AMDs eigene CUDA-Architektur)
Kernstärke: Alternative CUDA-Preisgestaltung; vertrautes GPU-Modell;
Ziel-Workload: Kostensensibles HPC und Inferenz in der Cloud
Schwachstelle: Softwarelücke im Vergleich zu CUDA; Rückstand gegenüber führenden Ökosystemen (z. B. NVQLINK)
Groq (von NVIDIA übernommen)
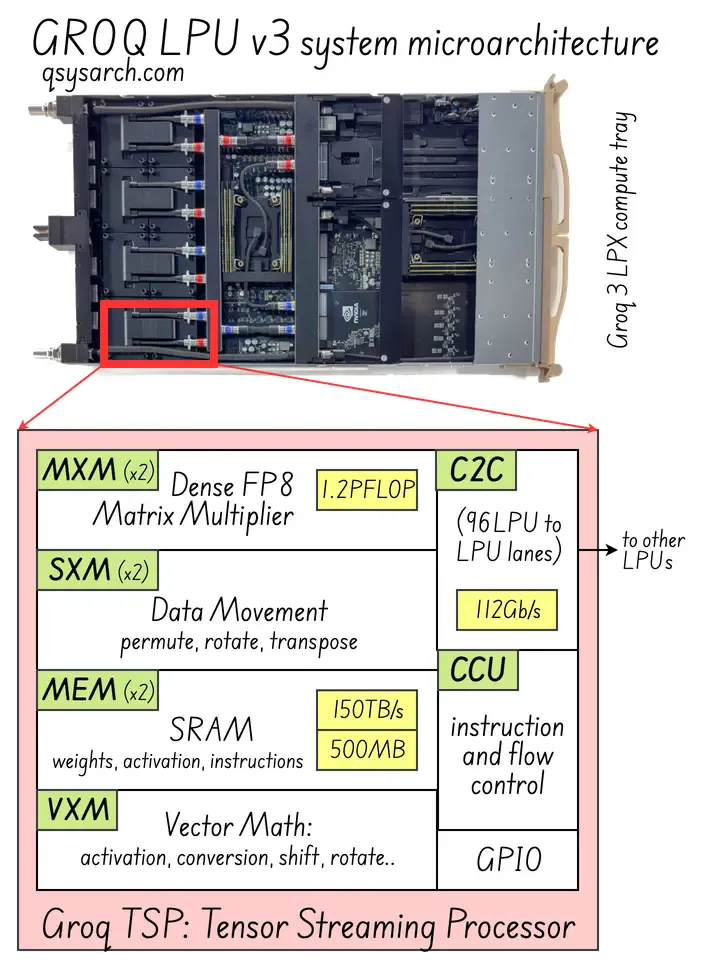
Architektur: LPU (Sprachverarbeitungseinheit)
Funktionsprinzip: Basierend auf der Kernarchitektur des Tensor Streaming Processors (TSP) ist die Ausführungszeit bis auf den genauen Taktzyklus vollständig vorhersagbar.
Kernstärke: Deterministische extrem niedrige Latenz; kein Speicherengpass; alles wird vom Compiler im Voraus “diszipliniert”.
Ziel-Workload: Echtzeit-Inferenz
Schwachstelle: Geschwindigkeit gegen Speicherplatz: Kein großer HBM-Speicher (High Bandwidth Memory), sondern nur kleiner, eingebetteter, superschneller SRAM (was ihn jedoch zu einer guten Ergänzung des Nvidia Blackwell-Ökosystems macht, seit dieses von NVIDIA übernommen wurde!).
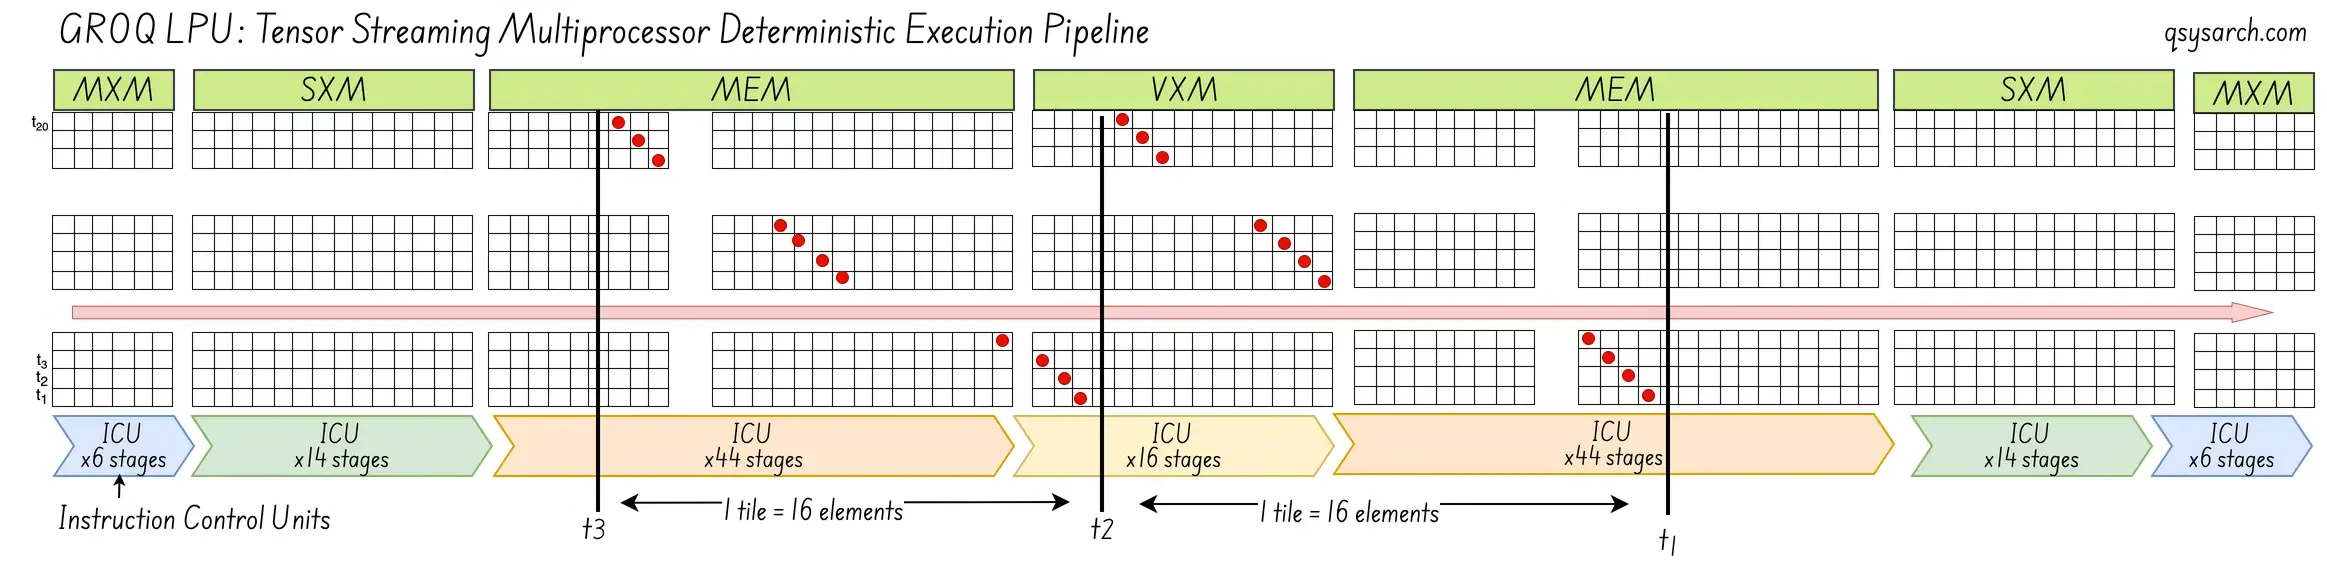
Man beachte, dass die Groq LPU-Architektur 2020 vorgestellt, 2024 kommerziell eingeführt und 2026 übernommen wurde. Dies bietet einen guten Zeitplan für angehende Unicorns: 4 Jahre für die Entwicklung, 2 Jahre zur Bestätigung der Marktakzeptanz und der Jackpot, wenn ein größerer Akteur den Druck der Konkurrenz spürt!
Eine gründliche Prüfung der unten aufgeführten Lösungen könnte für jeden Anbieter leicht einige Tage in Anspruch nehmen; Zeit, die ich für das Verfassen dieses Memos nicht hatte – daher sollten Sie die folgende Beschreibung mit Vorsicht genießen, da sie unvollständig und/oder subjektiv sein könnte.
SambaNova [fast von Intel übernommen]
- Architektur: RDU (rekonfigurierbare Datenflusseinheit); ermöglicht benutzerdefinierte, integrierte Daten- und Verarbeitungspipelines für den gesamten Berechnungsgraphen, minimiert Datenbewegungen und führt zu einer hohen Hardwareauslastung. Das folgende Diagramm zeigt die detaillierte Architektur der in SN40L verwendeten PCU (Pattern Compute Units) und PMU (Pattern Memory Units):
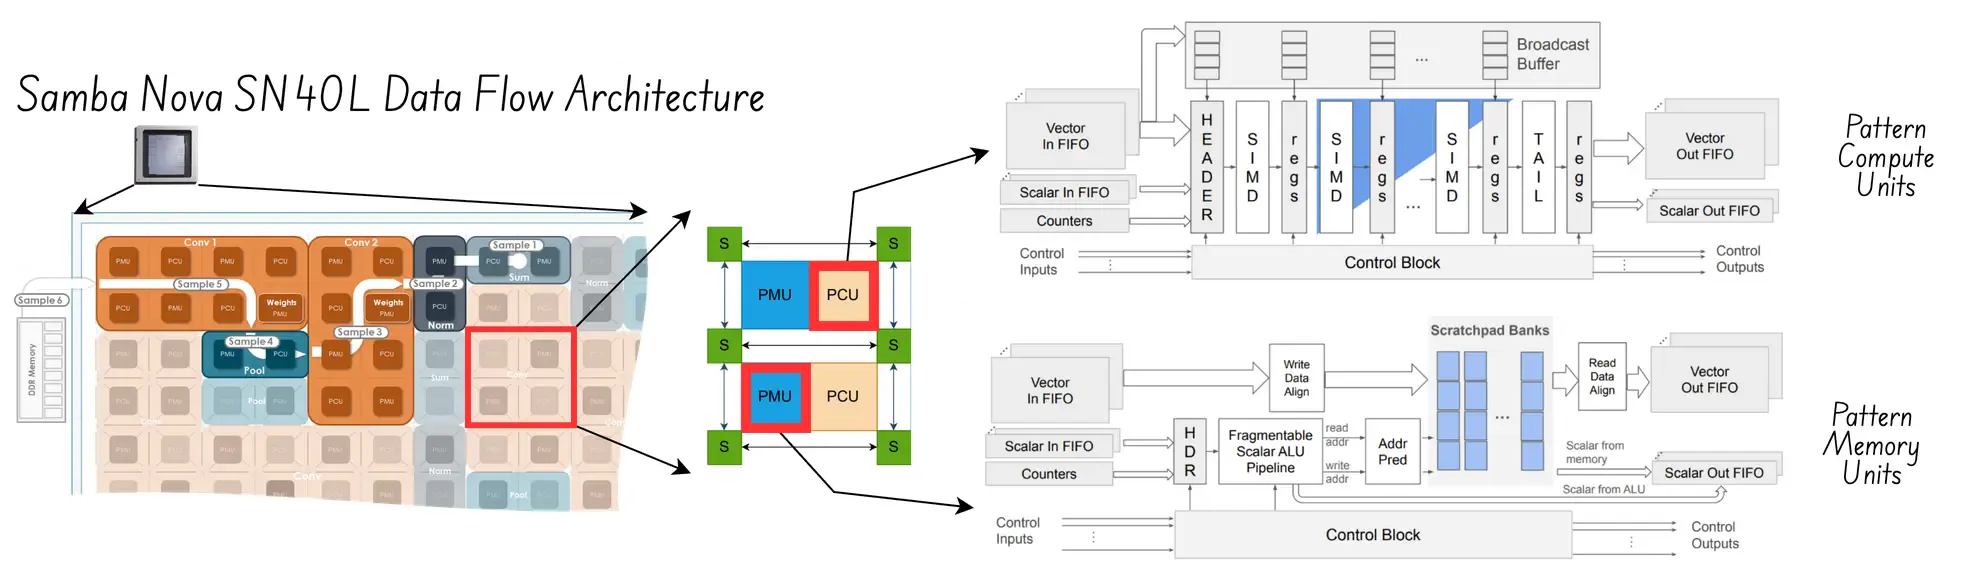
Kernstärke: Gewährleistet eine maximale Hardwareauslastung durch sorgfältige Partitionierung der Systemflüsse über die parallelen Inferenzpipelines; Enthält einen vollständigen Software-Stack, einschließlich High-Level-k8s-Integration, Compiler für PyTorch und TensorFlow sowie DataFlow-Analysatoren.
Ziel-Workload: Unternehmen, regulierte Branchen vor Ort.
Schwachstelle: hohe anfängliche Systemkosten für die Hardware, die über einen langen Zeitraum amortisiert werden müssen, damit die Gesamtbetriebskosten interessant sind.
Cerebras
Architektur: Wafer-Scale Engine (WSE) als riesiger, pipelined Matrixmultiplizierer.
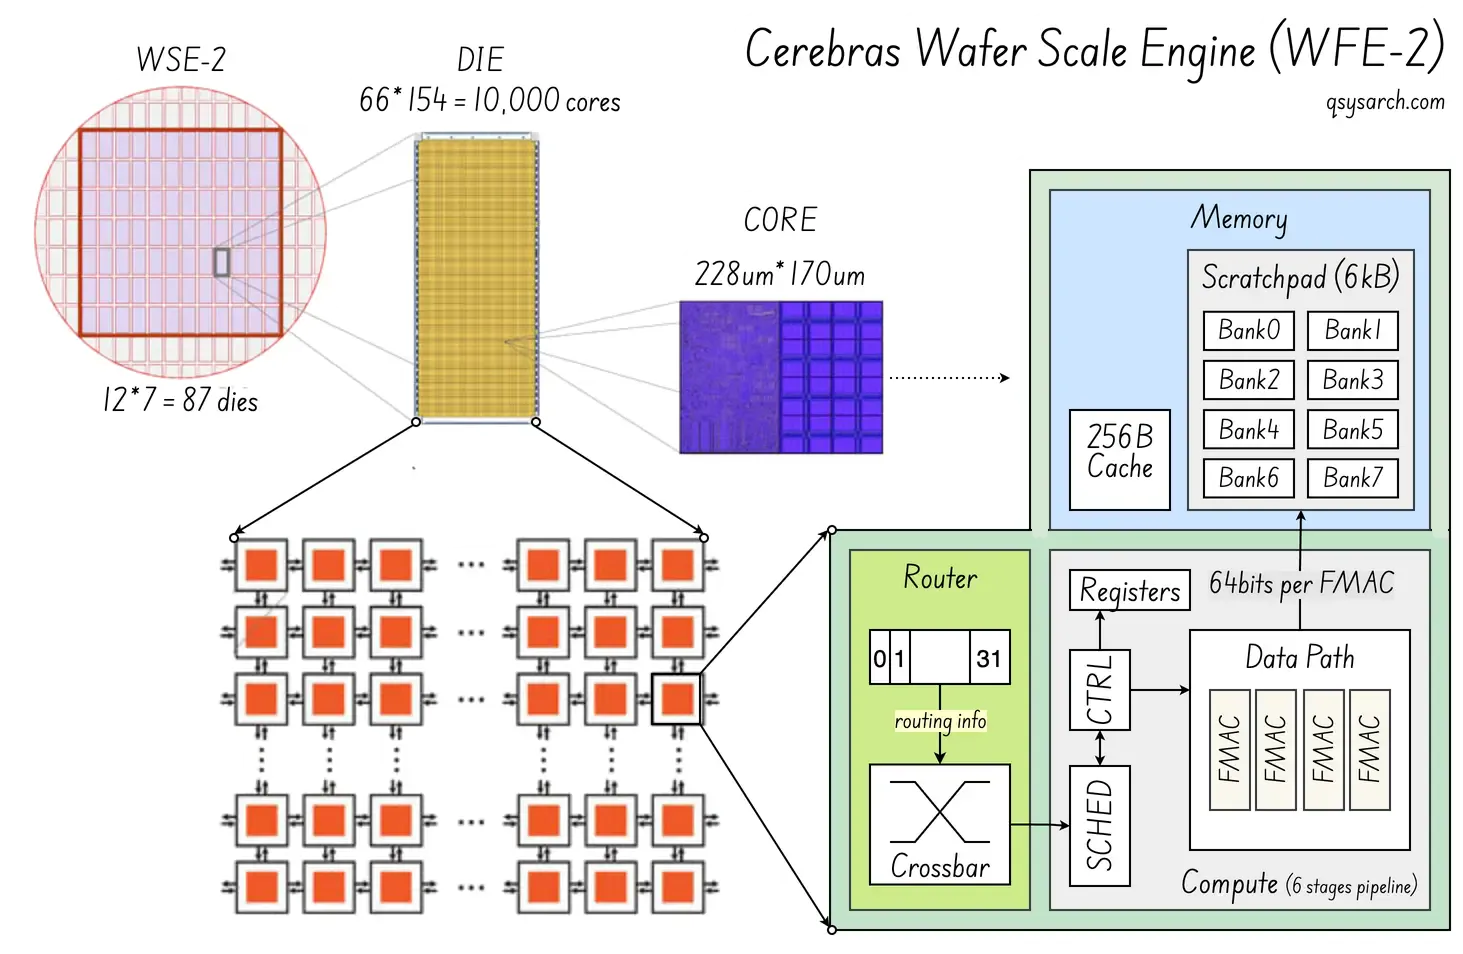
Kernstärke: Massiver On-Chip-SRAM, der den HBM-Flaschenhals beseitigt. Hochdichte, unabhängige Kerne (bis zu 850.000 beim WSE-2), die „Tensorberechnungen im Speicher“ ermöglichen. Fabric-Router mit einheitlicher Taktlatenz über alle Knoten auf dem Wafer.
Ziel-Workload: Inferenz großer LLM-Modelle, insbesondere spärlicher Modelle.
Schwachstelle: Erfordert einen erstklassigen Software-Stack, um die enorme Skalierbarkeit voll auszuschöpfen (wie bei allen “PIM”- oder Processing-in-Memory-Mikroarchitekturen).
FuriosaAI
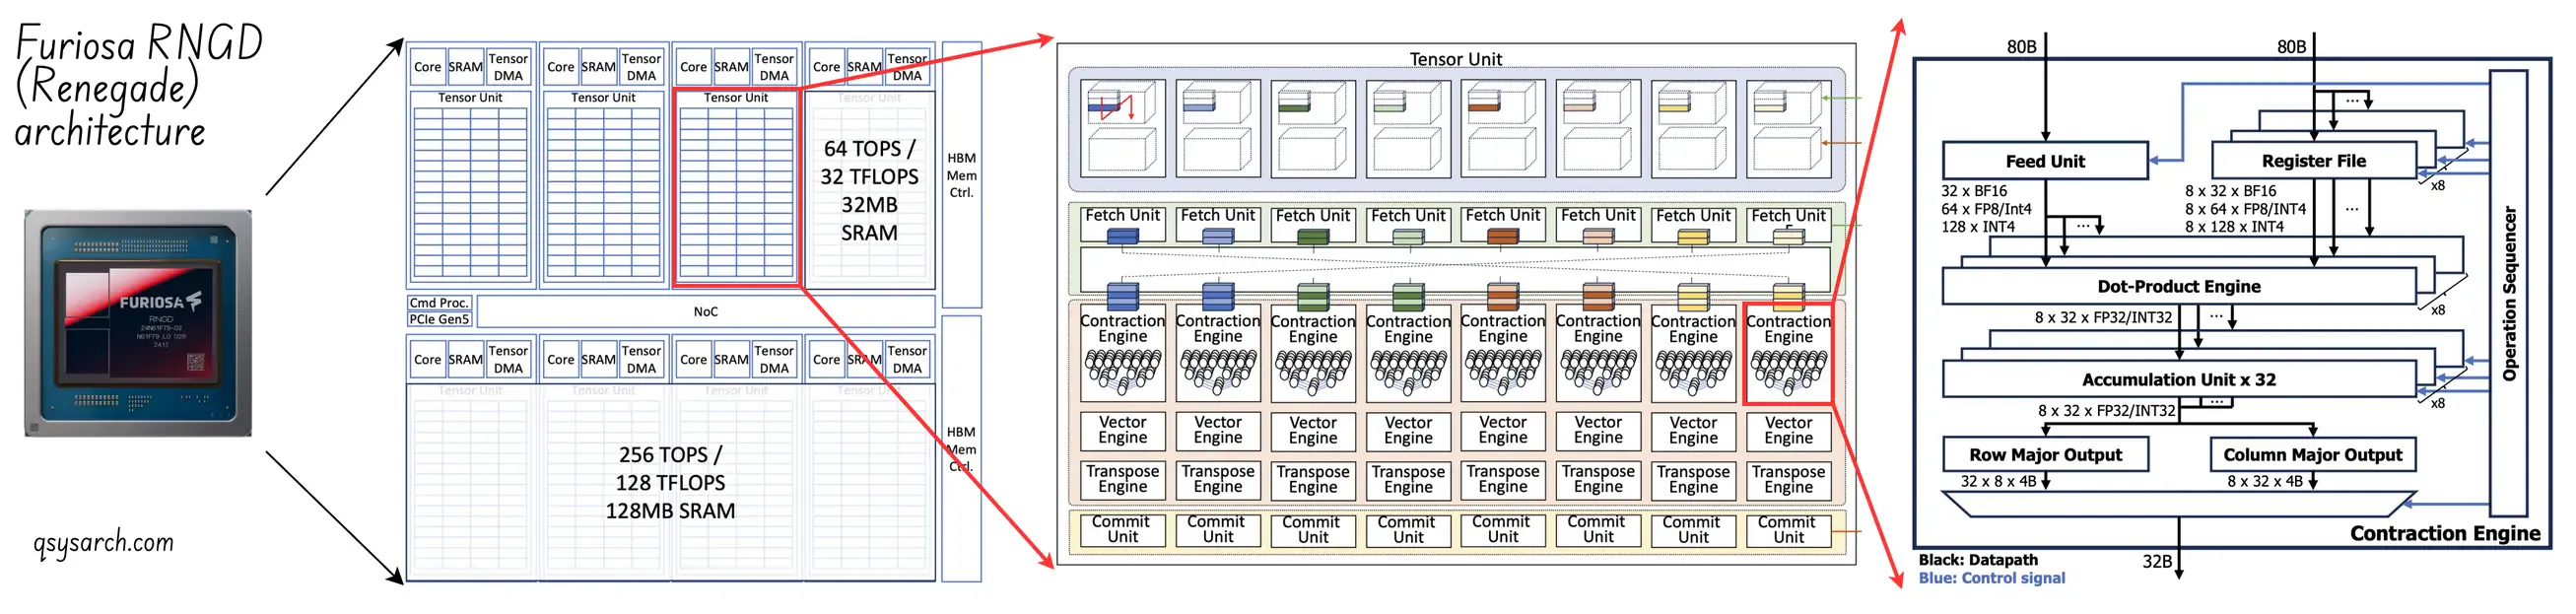
Kernstärke: Durch die Einführung des “fetch” NOC führt Furiosa die räumlich-zeitliche Programmierbarkeit des TPU-Tensornetzwerks ein und hebt die Effizienz auf die nächste Stufe, indem die Rechenlast und die Tensor-Kontraktionsprozessoren perfekt aufeinander abgestimmt werden.
Ziel-Workload: LLMs, VLMS,..
Schwachstelle: Begrenztes Ökosystem; Risiko geografischer Konzentration (dies könnte sich jedoch positiv auswirken, wenn sie einen Teil des asiatischen Marktes erobern – was bedeuten würde, dass sie beispielsweise für Intel, die ihren Marktanteil ausbauen wollen, ein guter Kauf wären)
Positron
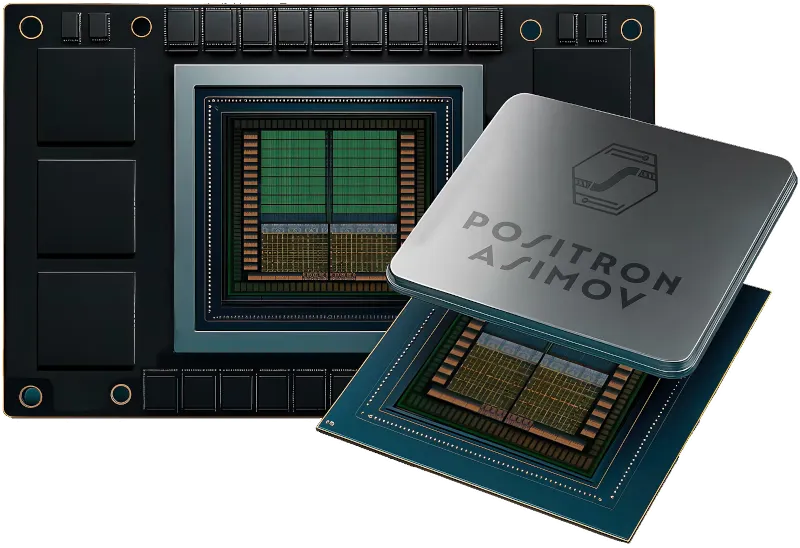
Architektur: Asimov ASIC - Es sind nicht viele Informationen verfügbar, aber die Kernaussage von Positron ist, dass der Speicher entscheidend ist: Wenn sie also deutlich mehr Standard-DDR5-Speicher in ihren ASIC integrieren können, indem sie Chiplet-Stacking verwenden, dann können sie im Vergleich zum NVIDIA Blackwell mit geringerer Speicherkapazität ein überzeugendes Angebot haben.
Kernstärke: Der Fokus liegt auf der Nutzung hoher Speicherbandbreite (MBU) anstelle der standardmäßigen hohen Speicherbandbreite (HBM). Dadurch können sie den Tastgrad bzw. die Auslastung des Speicherbusses erhöhen und somit eine gleichwertige (oder sogar bessere) Speicherleistung erzielen (Bandbreite * Tastgrad, wie bei Strom: V * I = Watt). Dadurch könnten sie die Konkurrenz überflügeln, die weiterhin mit teuren Speichern zu kämpfen hat.
Ziel-Workload: Wird sich zeigen, wenn der erste ASIC verfügbar ist - man kann aber vermuten, dass sie auf Standard-LLMs abzielen werden.
Schwachstelle: Sehr frühes Stadium und es müssen die richtigen Foundry-Partner gefunden werden; Sehr wahrscheinlich noch 2–4 Jahre bis zur allgemeinen Verfügbarkeit und kommerziellen Lösungen – wird der Speicher bis dahin immer noch ein Engpass sein?
Axelera AI:
- Architektur: Metis und Europe AIPU; Es handelt sich um eine In-Memory-Computing-Architektur mit einem auf RiscV basierenden Kontrolldatenflusssystem.
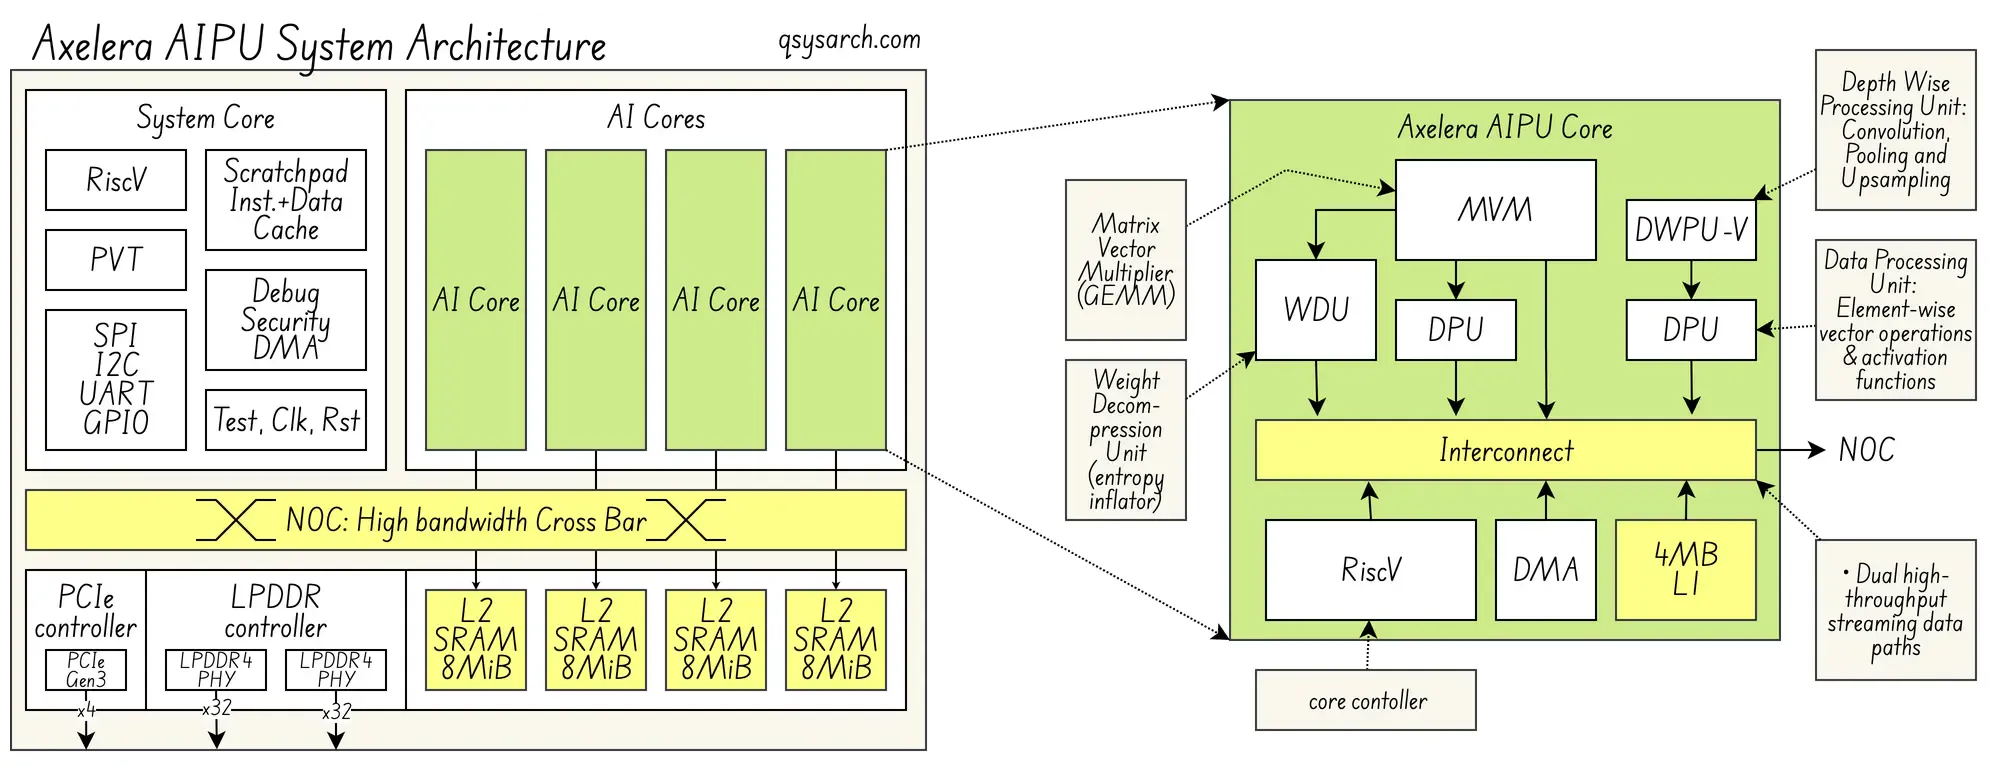
Kernstärke: Durch In-Memory-Computing kann es komplexe mathematische Operationen direkt in den digitalen Speicherzellen durchführen und so Datenbewegungen vermeiden. Dies ermöglicht eine Leistung von 15 TOPS/Watt (im Vergleich zu ca. 3 bei NVIDIA Blackwell). Da es sich zudem um eine vollständig in Europa entwickelte IP handelt, ist es eine souveräne Lösung.
Ziel-Workload: Die erste Generation konzentrierte sich auf Computer Vision / Multi-Stream-Videoanalyse; die neuere Generation (M2-Integration) kann auch für Edge-LLM- und vLM-Workloads verwendet werden.
Schwachstelle: Axeleras Schwachstelle liegt nicht in der Entwicklung – ihre Technologie ist Weltklasse. Ihre wahre Schwachstelle ist die Marktreibung: Können sie sich am Markt durchsetzen, ohne ihren Fokus zu verwässern?
Bei meiner Recherche zu den oben genannten Unternehmen stieß ich auf einige weitere innovative und disruptive Unternehmen im Fertigungssektor, die in den kommenden Jahren eine bedeutende Rolle spielen könnten. Und das letzte von ihnen, Unconventional AI, ist dank der bisherigen Erfolge und der Vision seines Leiters sicherlich nicht das unbedeutendste.

Extropic und Normal Computing
- Architektur: TSU (Thermodynamische Abtasteinheiten) / SPU (Stochastische Verarbeitungseinheit), die zur Verarbeitung von “p-Bits” (auch probabilistische Bits genannt) verwendet werden
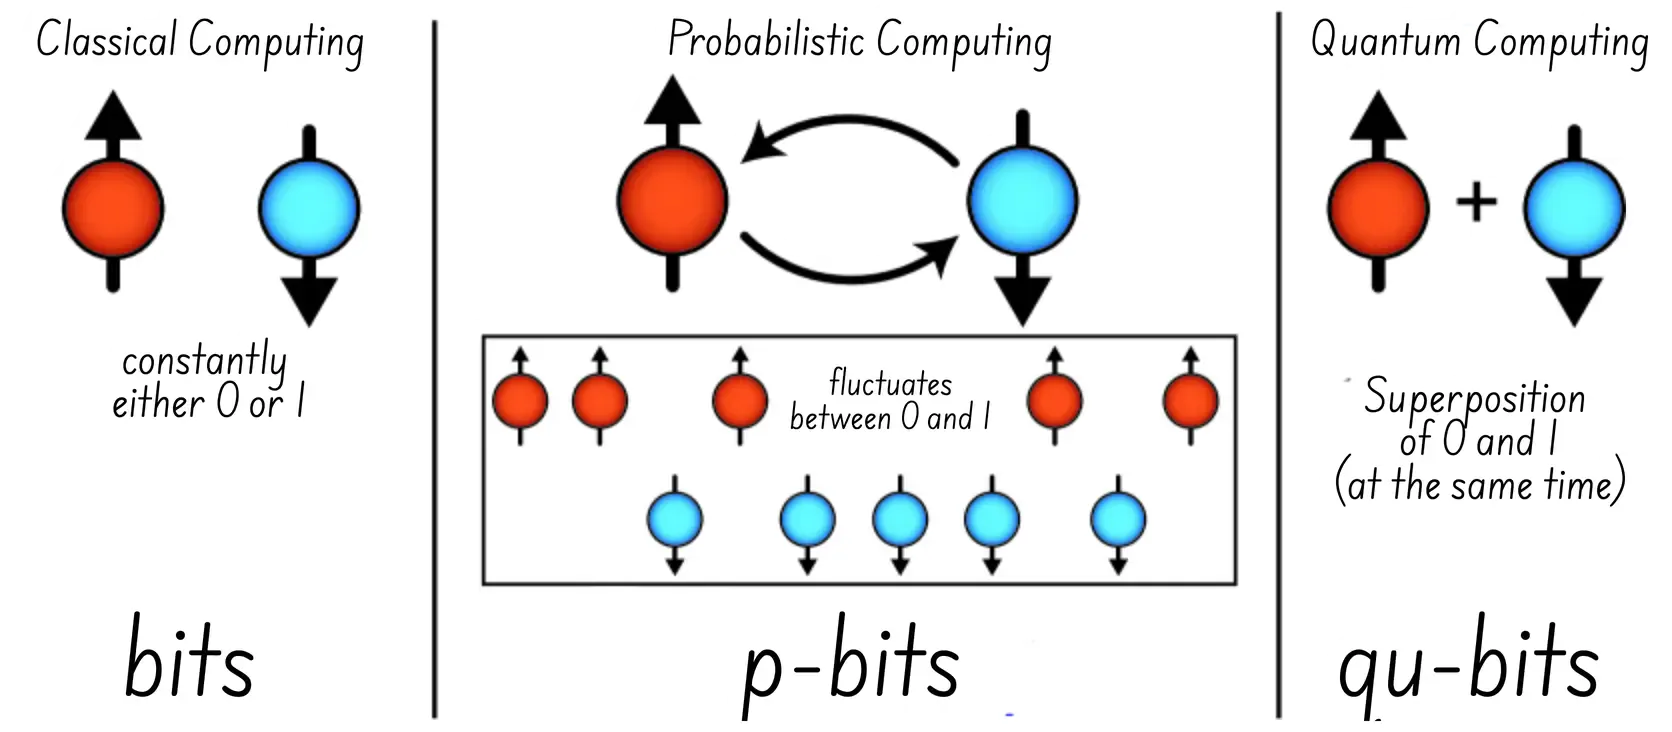
Warum das wichtig ist: Sie behaupten, bei bestimmten Arbeitslasten, wie z. B. Annealing, 10.000-mal effizienter als GPUs zu sein. Dies könnte eine erhebliche Herausforderung für Quantenbits darstellen.
- Schwachstelle: Die Nutzung in großem Umfang erfordert noch umfangreiche Forschung.
Mottronix
Architektur: SPU (Spiking Neural Network) unter Verwendung von Mott-Speichern (Mott-RAM).
Warum das wichtig ist: Wir brauchen vorausschauende Menschen, die sich mit alternativen Speichertechnologien beschäftigen, wie zum Beispiel dem resistiven Speicher (ReRAM) oder, im Falle von Mottronix, dem Mott RAM.
Schwachstelle: Muss beweisen, dass es von der Forschung zum marktfähigen IC überführt werden kann.
Akhetonics
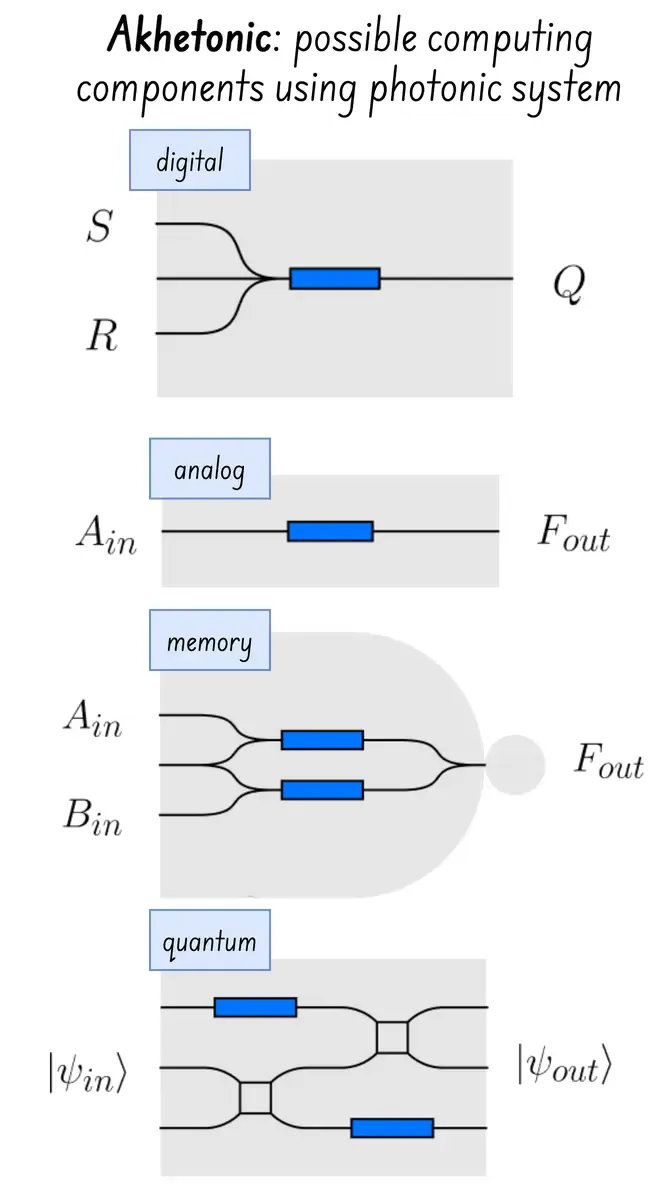
- Architektur: RPU (Reasoning Processing Unit) mit volloptischem Digitalprozessor
Warum das wichtig ist: Die Ausbeute photonischer ICs hat sich im letzten Jahrzehnt enorm verbessert – NVIDIA kann beispielsweise jetzt siliziumphotonische Netzwerk-Switches kommerziell herstellen – und die Anwendung dieser Technologie für Rechenlasten ist ein logischer nächster Schritt! (Dies ermöglicht auch optisch adressiertes Quantencomputing!)
- Schwachstelle: Es ist unklar, worin der Unterschied zwischen OAQ-Quantenberechnung und RPU-Schlussfolgerungsberechnung besteht, und in beiden Fällen ist eine sorgfältige Kalibrierung und Feinabstimmung erforderlich, bevor eine Skalierung zu kommerziellen Lösungen möglich ist.
Arago
- Architektur: “JEF” als photonischer KI-Beschleuniger, der eine 10- bis 30-fache Reduzierung des Energieverbrauchs ermöglicht - Die öffentlichen Informationen über Arago sind sehr begrenzt, aber es scheint sich um eine hybride deterministische/klassische + photonische Beschleunigerintegrationslösung zu handeln, kombiniert mit einem Full-Stack- und PyTorch-kompatiblen Software-SDK.
 Unkonventionelle KI
- Architektur: [UN]CPU ([Un]konventionelle Verarbeitungseinheit) mit Kuramoto-Oszillator
Warum das wichtig ist: Ich finde diese Idee großartig, und für ihre Umsetzung ist die richtige Wahl entscheidend: Den Mut zu haben, anders zu denken, ist nur die halbe Miete; die wahren Weltveränderer arbeiten täglich daran. Und dafür haben sie einen Leiter mit beeindruckender Erfahrung.
- Schwachstelle: Sie befinden sich noch am Anfang (Tag 0->1), daher ist die Ausführung entscheidend.
Wo verlaufen die aktuellen, wirklichen Konfliktlinien, die die gegenwärtige Marktlandschaft verändern könnten?
NVIDIAs struktureller Vorteil liegt nicht in der GPU, sondern im CUDA-Ökosystem, das in den letzten zehn Jahren entstanden ist. Um in diesem Wettbewerb zu bestehen, muss man nicht nur auf Silizium, sondern auch auf Software setzen – und genau daran scheitern viele innovative, hardwareorientierte Unternehmen.
AMD ist die am meisten unterschätzte kurzfristige Bedrohung für NVIDIA: Sie müssen CUDA nicht übertreffen, sie haben ihr eigenes Tool, und es muss für kostenbewusste Cloud-Käufer lediglich „gut genug“ sein. ROCm 6.x schließt die Lücke schneller als erwartet.
Die meisten Innovatoren versuchen, einen Kompromiss zwischen Zeit und Speicherplatz zu finden; entweder durch den Einsatz von ultraschnellem, lokalisiertem Speicher oder durch die Ermöglichung eines dynamisch konfigurierbaren Datenflusses (Pipelines). Derzeit ist der Arbeitsspeicher der Flaschenhals.
Vielleicht sind die Gewinner diejenigen, die beides gleichzeitig bewältigen können, was insbesondere für die Berechnung dünnbesetzter Matrizen (mit vielen „Nullen“) relevant ist, wo man zwar das Übertragen von Nullen in den Speicher vermeiden, aber dennoch Nullen berechnen möchte! Könnte Renegade den Unterschied ausmachen?
- Die Chiphersteller der nächsten Generation betrachten das Rechenproblem aus einem anderen Blickwinkel: Liegt der Schlüssel vielleicht darin, ein dynamisches System zu modellieren und zu speisen, anstatt Zahlen imperativerweise nacheinander zu multiplizieren?
Könnte die Datenkante eine sensible Grenze zwischen Quanten- und dynamischem Rechnen darstellen? Könnte dies sowohl die Herausforderung der Quantenkryotechnik als auch das Problem der Qubit-Dekohärenz lösen, indem ein Zwischensystem eingeführt wird, das exponentielles Rechnen ohne Qubit-Dekohärenz ermöglicht?
Technologie- und Marktentwicklung (2026–2029)
Link zu Überschrift
Die folgende Zusammenfassung stellt eine subjektive Einschätzung der zukünftigen Entwicklungen auf den Ebenen 1 bis 3 dar. Drei Veränderungen werden den nächsten Zyklus prägen. Sie sind nach ihrer Auswirkung geordnet.
Memory Power™: Speicher statt Rechenleistung ist der entscheidende Faktor für die quantitative Leistungssteigerung
Link zu Überschrift
LLMs werden zunehmend eher durch die Speicherbandbreite als durch die Rechenleistung begrenzt. Mit wachsenden Modellen und Kontextfenstern von über 1 Million Token dominieren die Kosten und Latenzzeiten für das Verschieben von Gewichten in/aus dem HBM. Der Zielkonflikt besteht zwischen speichernaher Datenverarbeitung mit On-Chip-SRAM und großem Speicher mit ausreichender Bandbreite: Der kritische KPI könnte die Speicherleistung werden, definiert als Bandbreite * Auslastungsgrad.
Mixture-of-Experts-Modelle, die nur einen Bruchteil der Parameter pro Token aktivieren (unter Verwendung einer dünnbesetzten Matrix), fallen ebenfalls in diese Kategorie: Die meisten Beschleuniger sind noch nicht für dünnbesetzte Aktivierungsmuster optimiert, weshalb NVIDIA den Tensor-Kern eingeführt hat. Dies ist möglicherweise nicht die endgültige Lösung, sondern eher eine Übergangslösung, bis eine robustere Alternative verfügbar ist.
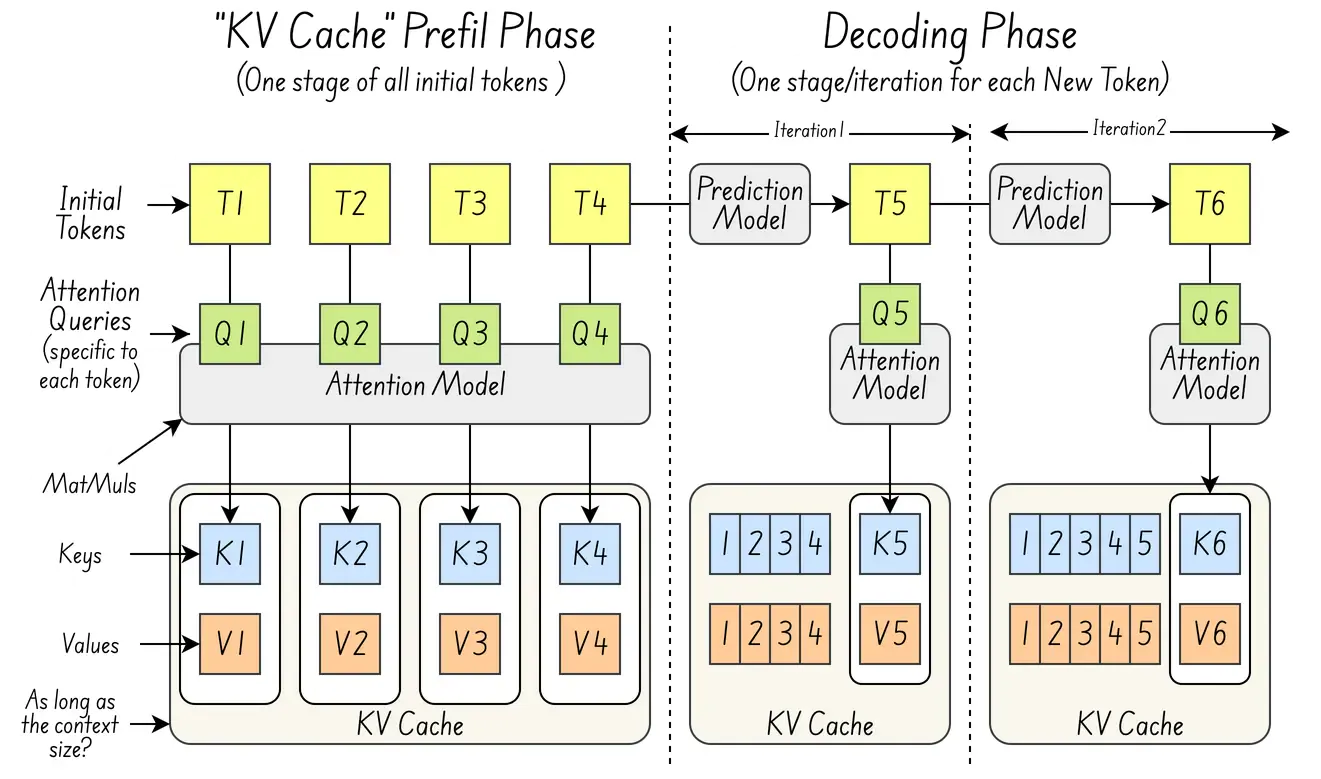 Beispielsweise ist es heutzutage üblich, die Prefill/Decode-Disaggregation (PD-Disaggregation) einzusetzen, um die Prefill-Phase (Aufbau des initialen KV-Caches aus vielen Token) und die Decode-Phase (Generierung eines Tokens nach dem anderen) eines LLM zu trennen. Dies ermöglicht den Einsatz speziell entwickelter Inferenz-Coprozessoren, da Prefill eine höhere Rechenleistung und Decode eine höhere Speicherkapazität benötigt (da für jedes Token eine neue KVQ geladen werden muss).
Der NVIDIA Tensor-Kern für spärliche Mixture-of-Experts-Modelle fällt ebenfalls in diese Kategorie.
HW-Kommodifizierung: Der Druck des Intelligenzindex treibt die Kommerzialisierung von Hardware voran.
Link zu Überschrift
Die Preise für Inferenz sind innerhalb von zwei Jahren um etwa das Zehnfache gesunken. Die Einführung von KI in Unternehmen wird nicht mehr durch die Modellqualität, sondern durch die Inferenzkosten gehemmt. Die Folge: Standard-Hardware für Inferenz wird unterhalb der High-End-Klasse (NVIDIA H100/B200) für die Bereitstellung von Standard-LLM verfügbar. Hier bietet sich für neue Anbieter die größte Chance. Stellen Sie sich vor, Sie könnten GLM5.2 auf Ihrer Standardhardware mit dem Positron Asimov-Prozessor ausführen!
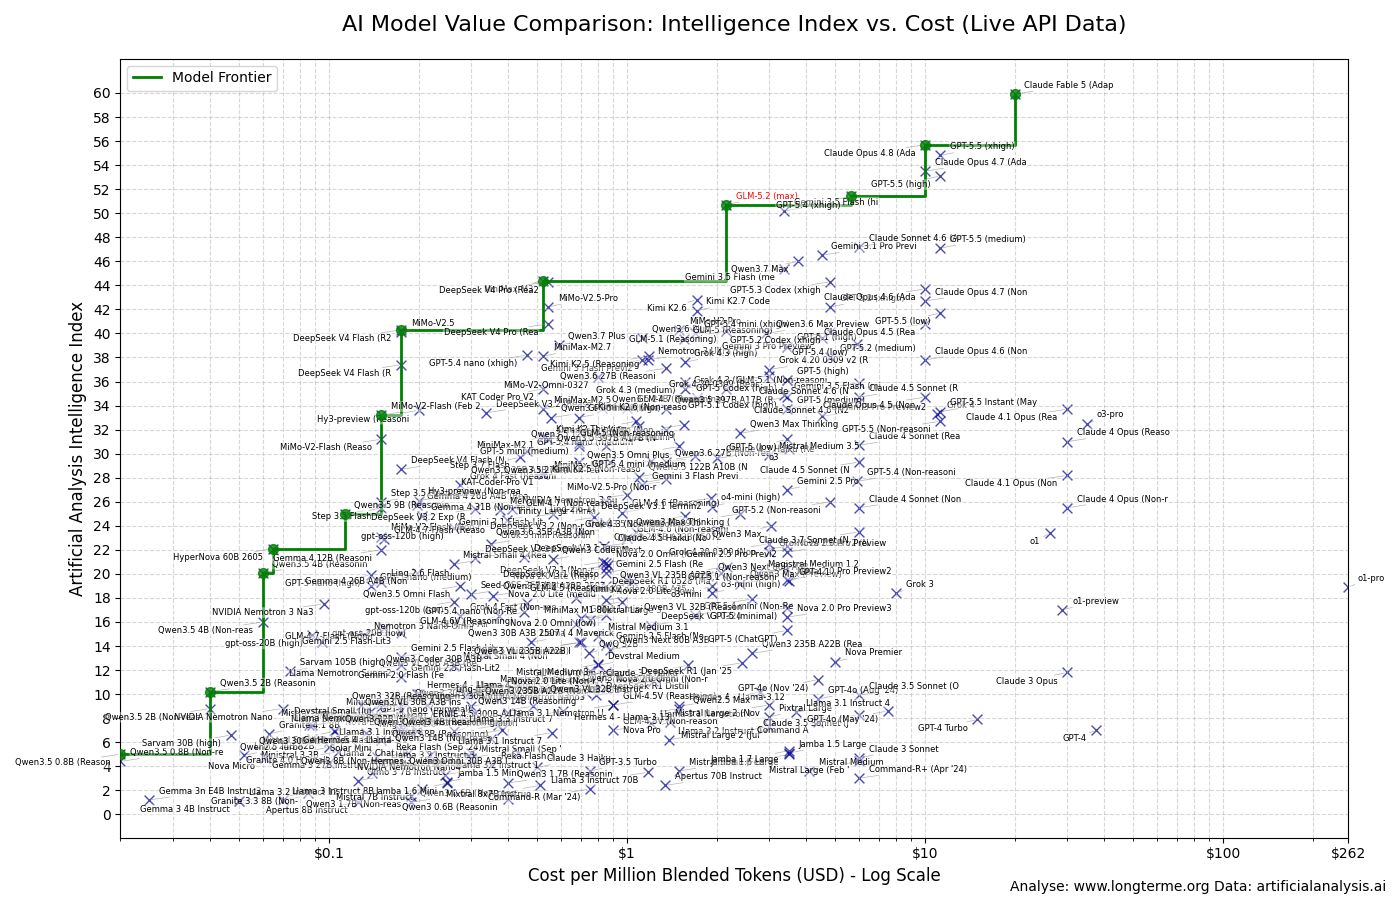 (Bildquelle: L’Observatoire du Long Terme – Z AI GLM5.2 ist ein klarer Außenseiter in Bezug auf Intelligenz/Kosten – erfordert aber fast 200 GB Speicher.)
Unternehmen unterschätzen systematisch die operative Komplexität. Anbieter, die Komplettlösungen für die Inferenztechnologie mit sofort einsatzbereiter Laufzeitumgebung (nicht nur Chips) liefern, werden einen überproportionalen Anteil am Kundenbudget der Unternehmen gewinnen.
Dies wird durch den Bedarf an On-Premise-Inferenz aufgrund des regulatorischen Drucks in der EU und im asiatisch-pazifischen Raum noch verstärkt, denn ja, viele Unternehmen wollen ihr proprietäres Wissen nicht auf ausländischen Systemen inferieren.
Der Markt für Inferenztechnologie wird 2024–2026 dem Netzwerkmarkt von 2000–2003 ähneln. NVIDIA steht damals vor einer ähnlichen Situation wie Cisco: dominant, für viele Anwendungsfälle überdimensioniert und zu einem Premiumpreis angeboten. Die Frage ist nicht, ob man NVIDIA bei seinen anspruchsvollsten Workloads herausfordern sollte. Vielmehr geht es darum, wo NVIDIA den Markt überversorgt und wo eine speziell entwickelte Alternative 80 % der Leistung zu 40 % der Kosten bieten kann.
Gleichzeitig investiert NVIDIA auch massiv in das Ökosystem, und die hervorragenden, vollständig quelloffenen Beiträge wie CudaQ und NVQLink, die NVIDIA der Community kostenlos zur Verfügung stellt, werden es für jeden Konkurrenten von NVIDIA schwieriger machen, diese Communities zu gewinnen.
Voilà, das war ein kurzes und oberflächliches Memo am Sonntagmorgen. Ich muss mich noch eingehender mit den architektonischen Details der zukünftigen Herausforderer befassen, und glücklicherweise werde ich im Laufe dieses Sommers zu mindestens zwei von ihnen ein Memo verfassen können. Das nächste Memo wird sich dann mit dem lang erwarteten Thema beschäftigen (auf das mich viele Leser gebeten haben): Quantenfehlerkorrektur – kurz erklärt!
https://api-docs.deepseek.com/news/news260424
SNN-Inferenz auf einer heterogenen neuromorphen Multi-Core-Plattform (SpiNNaker2) (https://arxiv.org/pdf/2406.17049)
In diesem Memo verwendete DrawIO-Diagramme: