Raph Levien ist bekannt für seine hocheffiziente Implementierung der schnellsten Glyphen-Rendering-Engine der Welt (https://medium.com/@raphlinus/inside-the-fastest-font-renderer-in-the-world-75ae5270c445), die auf einem ausgeklügelten, in Rust geschriebenen SIMD-Design basiert. Seine Arbeit inspirierte mich sehr, als ich 2023 bei Bestechnics eine SIMD-GPU entwickelte. Später arbeitete Ralf Levien auch an einer GPU-Version dieses Glyphen-Renderings (https://raphlinus.github.io/rust/graphics/gpu/2020/06/13/fast-2d-rendering.html).
Als ich also zufällig auf seinen neuesten Vortrag zum Thema „Wie Rust gewann: Die Suche nach performanter, zuverlässiger Software“ stieß, beschloss ich kurzerhand, mir eine Stunde Zeit zu nehmen, um den Vortrag anzusehen und alle lehrreichen Erkenntnisse mitzunehmen.
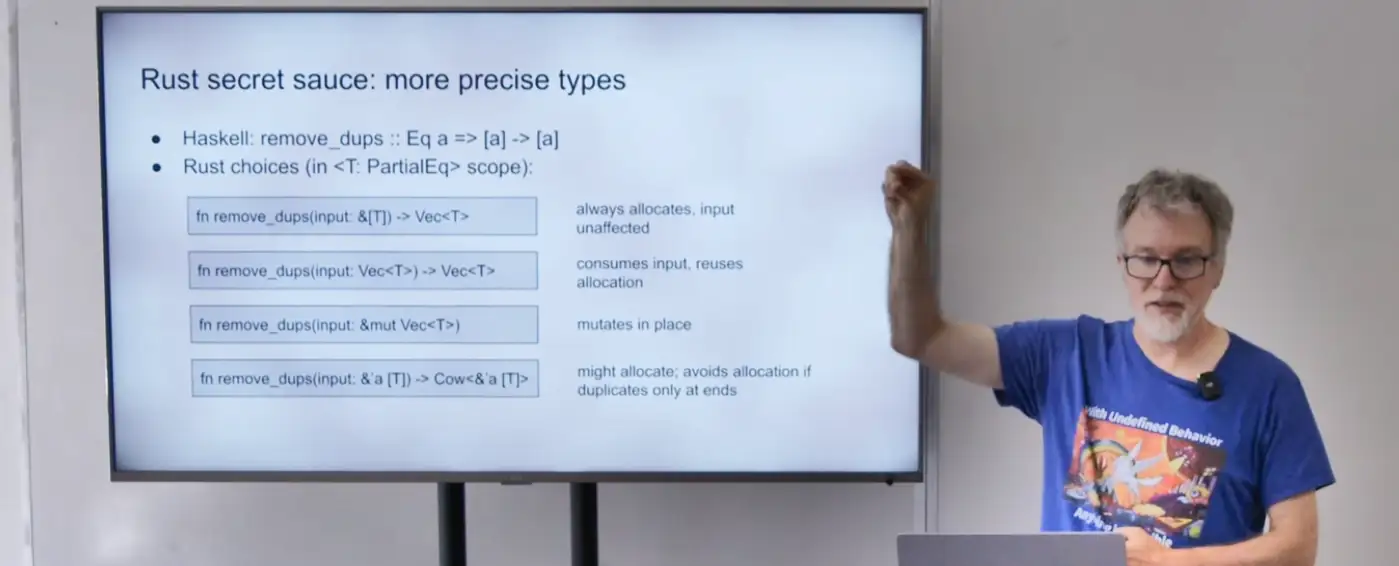
Der spannende Teil (auch bekannt als die Ertrinkungszone) beginnt etwa bei 55:00 mit einer Folie mit dem Titel Rust geheime Soße: genauere Art.
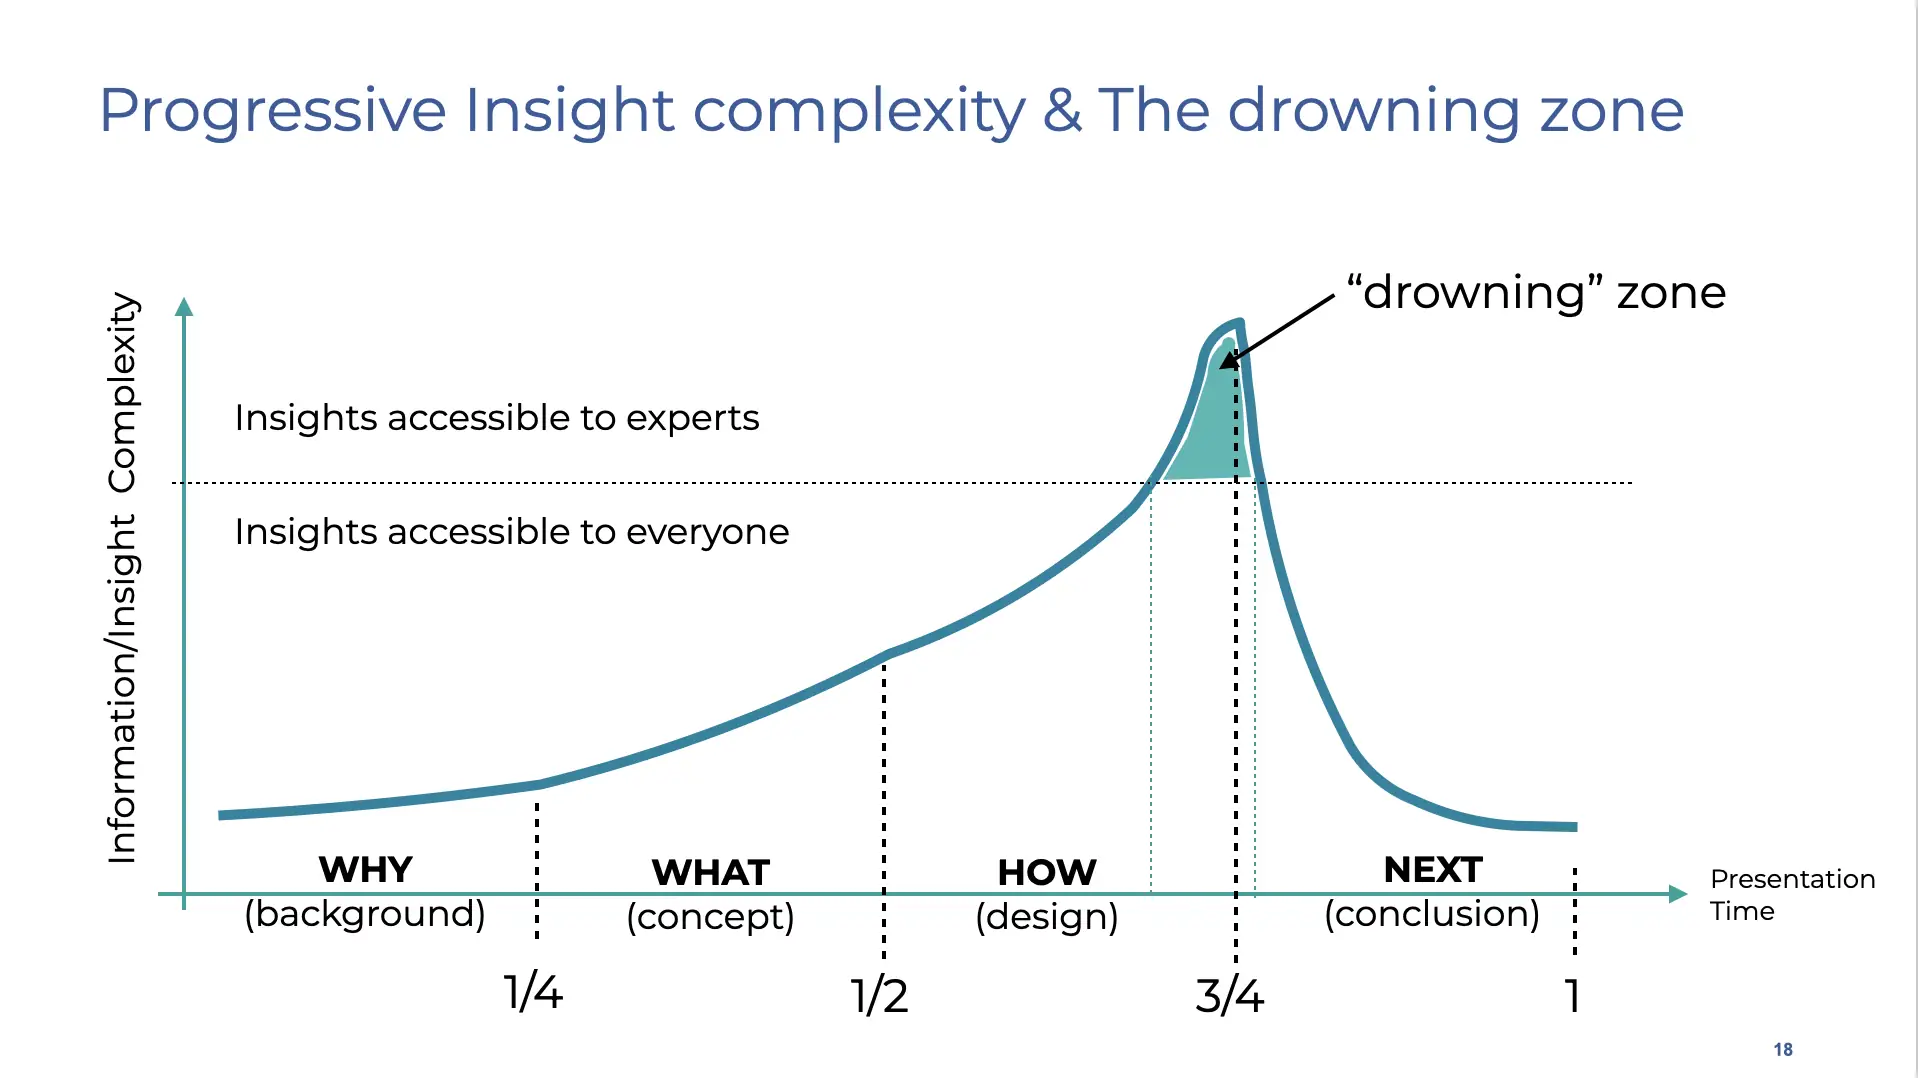
Bei 56:50 sagt Raph: „Hier kommt der affine Typ ins Spiel; man möchte (die Klonbarkeit) als ‚eine Instanz davon existiert‘ modellieren; und der Typ ermöglicht es, in der Funktionssignatur genau festzulegen, wie diese Besitzverhältnisse gehandhabt werden; Und ich werde das letzte Beispiel überspringen, aber es ist doch interessant, oder …“
Ich gebe keineswegs vor, ein Rust-Experte zu sein, und ich neige zugegebenermaßen etwas zu Go – daher meine Frage: Kann ich verstehen, was der affine Typ wirklich bedeutet? Und lässt er sich in einfachen Worten erklären, ohne dass man in einem Meer von Fachwissen ertrinken muss?
Eine weitere Frage, die in den YouTube-Kommentaren aufgeworfen wird: Offenbar sollte der Rückgabetyp der letzten Funktion Cow<'a, [T]> anstatt Cow<&'a [T]> lauten. Ehrlich gesagt erscheint mir das noch komplizierter als Quantenalgorithmen. Aber vielleicht muss es ja gar nicht so sein!
Schauen wir uns diese Beispiele für „präzisere Geheimrezepte“ genauer an:
fn α( l: &[T] ) → Vec<T> : allokiert immer, Eingabe bleibt unberührt
fn β( l: Vec<T> ) → Vec<T> : verbraucht die Eingabe und verwendet die Zuweisung wieder.
fn δ( l: &mut Vec<T> ): Keine Speicherzuweisung, verändert lediglich den Eingabevektor
fn ω( l: &'a [T]) → Cow<'a,[T]>: Speicherzuweisung möglich; Zuweisung vermeiden, wenn Duplikate nur an den Enden vorhanden sind
Das erste Problem, das im generischen Template T überprüft werden muss? Funktioniert es wirklich? Lassen sich diese Funktionen so kompilieren? Probieren wir es mit der einfachsten Version der Funktion aus:
// fails with: error cannot find type T in this scope
fn α( l: &[T] ) -> Vec<T> { vec![] }
Das funktioniert offensichtlich nicht und schlägt mit der Fehlermeldung „Typ T in diesem Gültigkeitsbereich nicht gefunden“ fehl. Wenn Sie mit C++ vertraut sind, würden Sie erwarten, dass der Typ T zusammen mit dem Funktionsnamen deklariert werden muss, also die Deklaration von α stattα`.
// all right with the T declaration
fn α<T>( l: &[T] ) -> Vec<T> { vec![] }
So funktioniert es einwandfrei! Fügt man jedoch eine einfache Implementierung hinzu (die lediglich in vec konvertiert, ohne die Duplikate zu entfernen), schlägt der Compiler mit der Fehlermeldung fehl, dass die Trait-Beschränkung T: Clone nicht erfüllt ist.
// fails with: the trait bound `T: Clone` is not satisfied
fn α<T>( l: &[T] ) -> Vec<T> { l.to_vec() }
Glücklicherweise bietet Rust eine sehr gute Dokumentation zu den generischen Eigenschaften und Traits, und nach zehnminütigem Lesen wurde deutlich, dass wir das α ändern müssen. zuα<T: Clone> ` als Mittel, um die Merkmalsgrenze vom Typ T auszudrücken.
// all right with the trait bound
fn α<T: Clone>( l: &[T] ) -> Vec<T> { l.to_vec() }
Der nächste Schritt besteht darin, eine Lösung zum Entfernen von Duplikaten zu implementieren. Ein Ansatz hierfür ist die Verwendung eines HashSets. Zunächst wird das Array in einen Iterator umgewandelt (let iterator: std::slice::Iterator). = l.iter();), und dann erstellen wir ein Hash-Set aus diesem Iterator (HashSet::from_iter(iterator)), und schließlich konvertieren wir das Hash-Set in einen Vektor set.into_iter().collect()`.
//Fails with: the trait bound `T: Eq` is not satisfied
use std::collections::HashSet;
fn α<T: Clone>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Wie erwartet, schlägt das fehl! Und das ist auch normal, denn hätte man sich die zehn Minuten Zeit genommen, die Rust-Dokumentation zu Traits zu lesen, wüsste man, dass HashSet wahrscheinlich etwas benötigt, das die Elemente vom Typ T vergleichen kann. Genau das leistet das Eq-Trait – also fügen wir es einfach der Trait-Grenze hinzu (von α).<T: Clone> zuα<T: Clone + Eq> `):
//Fails with: the trait bound `T: Hash` is not satisfied
use std::collections::HashSet;
fn α<T: Clone + Eq>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Es funktioniert immer noch nicht, und zwar deshalb, weil wir vergessen haben zu erwähnen, dass der Typ T in einen Hashwert umgewandelt werden können muss. Genau das leistet das Hash-Trait. Ändern wir also von α<T: Clone + Eq> zuα<T: Clone + Eq + Hash> `
//Fails with: a value of type `Vec<T>` cannot be built from an iterator over elements of type `&T`
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Hier kommt der interessante Teil der Klonbarkeit ins Spiel: Das Hash-Set ist eine Struktur, die Zeiger auf die Elemente enthält, die ursprünglich in der Liste vorhanden waren und per Wert übergeben wurden (genauer gesagt, wurde das Array per Zeiger übergeben und enthielt Elemente, auf die per Wert verwiesen wurde). Wir müssen dem Hash-Set also mitteilen, dass es eine Kopie dieser Elemente erstellen soll. Dies geschieht durch Hinzufügen von cloned() vor dem letzten collect-Aufruf (der collect-Aufruf dient dazu, den Iterator in eine Vektor-Collection umzuwandeln).
// all right!
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().cloned().collect()
}
Und voilà, wir sind bereit für das erste Funktionsbeispiel:
fn main() {
println!("{:?}", α(&["A","A","B","D"]));
println!("{:?}", α(&[1,1,2,4]));
}
Ehrlich gesagt, ist das gleichzeitig komplex und nicht komplex. Komplex, weil der Compiler strenge Regeln durchsetzt, die explizit deklariert und nicht implizit abgeleitet werden müssen, was die Lernkurve steil macht. Nicht komplex, weil es, sobald man die „10 Minuten“ zum Lesen der Dokumentation investiert hat, eigentlich einfacher sein sollte. Vielleicht liegt das Problem nicht darin, dass das Lesen der Dokumentation 10 Minuten dauert, sondern vielmehr darin, dass es 10 Stunden dauert, das Geschriebene zu verstehen. Das ist ein Déjà-vu-Erlebnis…
Ich habe noch eine Frage zur Klonbarkeit. Könnten wir einen Vektor zurückgeben, der nur Referenzen auf die Elemente des übergebenen Arrays enthält? Auf den ersten Blick müsste man dafür lediglich Vec ändern. zuVec<&T>` … und die affinen Typbeschränkungen korrekt behandeln? Versuchen wir es:
// All right - works fine
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<&T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Gut, das funktioniert! Und keine Beschwerden bezüglich der Lebensdauer? Ich meine, handelt es sich nicht um einen Fall, in dem wir die Elemente ausleihen, sodass die Lebensdauer überprüft werden sollte? Liegt das Problem vielleicht darin, dass unsere main-Funktion zu einfach ist? Versuchen wir also etwas Komplexeres:
// fails with expected named lifetime parameter
fn limited_lifetime() -> vec<&str> {
let l = ["A","A","B","D"];
α(&l)
}

fn main() {
let v = limited_lifetime();
println!("{:?}",v);
}
Diesmal schlägt es fehl: Der Compiler meldet einen fehlenden Lebensdauerparameter. Nehmen wir uns also die zusätzlichen 10 Minuten Zeit, um die Rust-Dokumentation zum Thema „Validierung von Referenzen mit Lebensdauern“ (https://doc.rust-lang.org/book/ch10-03-lifetime-syntax.html) zu lesen. Auf den ersten Blick scheint es, als müssten wir lediglich das ‘a ? hinzufügen.
//  fais with: mismatched types; expected `&[str]`, found `&[&str; 4]`
fn limited_lifetime<'a>() -> Vec<&'a str> { ... }
Aber nein, das funktioniert nicht. Versuchen wir, den “unveränderlichen str” in einen dynamischen “String” umzuwandeln:
// fails with: cannot return value referencing local variable `l`
fn limited_lifetime<'a>() -> Vec<&'a String> {
let l = ["A".into(),"A".into(),"B".into(),"D".into()];
α(&l)
}
Okay, das ist tatsächlich der erwartete Fehler – die Ausleihprüfung funktioniert. Aber wie können wir dem Compiler mitteilen, dass die Besitzrechte für die lokal allokierten Variablen übertragen werden sollen? Dazu müssen wir dem Compiler mitteilen, dass das Array l auf dem Heap allokiert werden soll. Und dafür benötigen wir einen vec anstelle des Arrays.
// this works
fn β<T: Clone + Eq + std::hash::Hash>( l: Vec<T> )  -> Vec<T> {
let hash_set: HashSet<_> = l.into_iter().collect();
hash_set.into_iter().collect()
}

fn limited_lifetime<'a>() -> Vec<&'a str> {
let l2 = vec!["A","B","B","D"];
β(l2)
}

fn main() {
println!("{:?}",limited_lifetime());
}
Diese Version funktioniert tatsächlich, weil die neue β-Funktion einen Vektor von Elementen entgegennimmt und dasselbe Element zurückgibt, anstatt eines Zeigers darauf. Die Elemente werden also geklont. Was aber, wenn wir stattdessen möchten, dass die β-Funktion einen Zeiger auf die Eingabeelemente zurückgibt?
Dritte Herausforderung: Klonen beim Schreiben
Link zu Überschrift
Erinnert ihr euch an die „Kuh“ in der letzten Omega-Funktion?
fn ω( l: &’a [T]) → Cow<&’a [T]>
Cow ist eigentlich ein Enum. Es kann entweder eine unveränderliche (geliehene) Referenz oder eine veränderliche Kopie desselben enthalten. Zum Beispiel:
use std::borrow::Cow;
fn trim_input(input: &str) -> Cow<str> {
if input.ends_with(' ') {
Cow::Owned(input.trim_end().to_string())
}
else  Cow::Borrowed(input)
}
Müssen wir also Cow<'a [T]> oder Cow<&'a [T]> schreiben? Auf den ersten Blick scheint es so, da die Eingabe ein Zeiger & mit der Lebensdauer 'a auf ein Objekt vom Typ [T] ist, und die Ausgabe ebenfalls ein Zeiger auf ein Objekt desselben Typs ist. Der Unterschied besteht darin, dass Cow<> auch für Zeiger steht. Daher ist die korrekte Antwort tatsächlich Cow<'a, [T]>.
fn ω<'a, T>( l: &'a [T]) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
Das Interessante daran ist, dass Arrays in Rust eine zur Kompilierzeit festgelegte Länge haben. Wie könnten wir also zur Laufzeit ein neues Array mit dynamischer Größe allokieren? Offenbar ist das laut diesem Stack-Overflow-Kommentar nicht möglich. Vielleicht meinte Ralf stattdessen vec?
fn ωx<'a, T: Clone + Eq + std::hash::Hash>( l: &'a Vec<T>) -> Cow<'a, Vec<T>> {
let hash_set: HashSet<_> = l.into_iter().collect();
if hash_set.len()==l.len() {
return Cow::Borrowed(l);
}
let own_copy = hash_set.into_iter().cloned().collect();
return Cow::Owned(own_copy);
}
Ehrlich gesagt muss ich mir eingestehen, dass ich mich in der Syntax “fn ω<‘a, T>( l: &‘a [T]) -> Cow<‘a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }” ertrunken habe, was eigentlich nur “ein Klon desselben” bedeuten sollte.
Wenn wir berücksichtigen, dass &'a T als Ptr<'a,T> umgeschrieben werden kann, dann können wir die Funktion auch wie folgt umschreiben:
fn ω<'a, T>( l: Ptr<'a, [T]>) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
Wenn wir die Tatsache außer Acht lassen, dass T ein Array ist, kann der obige Code wie folgt umgeschrieben werden:
fn ω<'a, T: ToOwned>( l: Ptr<'a, T>) -> Cow<'a, T> { Cow::Borrowed(l) }
Wie wäre es dann, den Typ als makrobasierten Ausdruck anstatt als Syntax neu zu schreiben?
fn ω<'a, T>( l: Ptr<'a, T> ) -> !Cow(l) { Cow::Borrowed(l) }
Durch die Möglichkeit, Code umzuschreiben, kann das Makro !Cow(l) implizit festlegen, dass der Typ T an das Trait ToOwned gebunden werden muss. So betrachtet, könnten wir davon ausgehen, dass 'a und T generische Typen sind, die bei Verwendung des Traits Ptr nicht explizit angegeben werden müssen.
fn ω( l: Ptr ) -> !Cow(l) { Cow::Borrowed(l) }
Was daran so verwirrend ist, ist, dass wir sowohl den Kompilierzeittyp als auch die Laufzeitimplementierung ohne jegliche Unterscheidung angeben. Aber vielleicht ist das ja gerade das Wesen von Rust?
Ich denke, Ralfs „Geheimrezept“ ist so komplex, dass man es in einer Stunde ausführlich erklären und mit eigenen Folien präsentieren könnte – nicht nur in drei Minuten eines einstündigen Vortrags. Eine kritische Betrachtung wäre auch angebracht; vielleicht ist ja nicht alles so unterhaltsam? Vielleicht ist es etwas zu komplex und schreckt dadurch einige Entwickler ab? Und vielleicht ist genau das der „Spaß“ daran? Wie dem auch sei, ich werde in den nächsten Wochen versuchen, ein paar Folien für einen einstündigen Vortrag vorzubereiten.
Zurück zur Herausforderung des Quantencomputings: Brauchen wir ein ähnliches Komplexitätsniveau, damit Quantencomputersysteme funktionieren? Liegt darin vielleicht die Herausforderung von heute? Obwohl Quantenalgorithmen scheinbar komplex sind, wirken sie im Vergleich zu dieser schwer verständlichen Rust-Syntax recht einfach. Müssen wir womöglich einen Schritt vorausdenken, um die Frage nach dem praktischen Nutzen von Quantencomputern zu lösen? Und werden wir ohne diese zusätzliche Komplexität weiterhin nur grundlegende Berechnungen durchführen können?
Angenommen, es geht hier ausschließlich um die Semantik der Objekte, die wir manipulieren wollen, dann müssen wir vielleicht erkennen, dass es eine logische Abstraktionsebene über den Qubits gibt, die noch nicht erkennbar ist, weil die Industrie immer noch damit zu kämpfen hat, Qubits zum gewünschten Verhalten zu bringen.